当 AI 接管代码,优雅还值得追求吗?
开发者正在经历一种微妙的身份变化。
过去,我们打开编辑器,思考应该修改哪个函数、如何拆分模块、怎样验证实现。现在,我们越来越多地直接告诉 Codex:“完成这个功能,把测试跑通。”
代码仍然存在,但它开始退到任务之后。人的工作从亲手实现,转向描述目标、提供约束,再验收结果。
一个问题随之出现:如果代码主要由 AI 编写和维护,我们还需要像过去那样,认真追求程序设计与代码结构的优雅吗?
有人已经尝试让人类退出代码生产和审查。另一些长期研究软件设计的人则认为,生成能力越强,我们越需要理解自己正在构建什么。
这场分歧涉及软件工程的几个基本问题:我们如何知道软件做对了,如何应对下一次变化,以及代码结构究竟在帮助谁。
有人已经准备关掉软件工厂的灯
2026 年 1 月,Glowforge CEO Dan Shapiro 用自动驾驶的分级方式,描述 AI 编程从辅助工具走向自主生产的过程。
其中一个阶段,许多开发者已经非常熟悉:AI 不断生成代码,人不断阅读差异。写代码的工作减少了,审查工作却几乎填满了一天。
Shapiro 把更高程度的自动化称为 Dark Factory,即“黑灯工厂”,并用一句话描述它:
“It’s a black box that turns specs into software.”
一个把规格说明变成软件的黑箱。
在这一设想中,人决定要什么,系统负责把它做出来。他还认为,随着代码生产成本下降,团队需要重新计算技术债的偿还时机。今天昂贵的人工整理,未来可能由更便宜的 AI 完成。来源:Dan Shapiro,2026-01-23
这触碰了软件工程中一个长期默认的前提:我们精心组织代码,是为了让未来的修改更便宜。
如果修改和重写本身越来越便宜,提前为它们投入大量设计,是否还划算?
这个问题值得问。但生成便宜了多少,以及验证、替换旧实现需要付出多少成本,仍然要分别计算。
StrongDM 更进一步:人也不要审代码
StrongDM 联合创始人、CTO Justin McCarthy 把类似想法变成了团队实验。
2026 年 2 月,他公开介绍的软件工厂有两条规则:
“Code must not be written by humans”
“Code must not be reviewed by humans”
不由人编写代码,也不由人审查代码。
第二条尤其激进。我们已经习惯“AI 写、人来审”,但 McCarthy 希望把审查环节也交给自动化流程。
他们遇到的第一个障碍就是验证。代理可能通过投机方式满足测试,甚至修改测试来迁就实现。团队因此引入代码库之外的验收场景,并构建外部服务的行为模拟环境,检查更广泛的交互与故障情况。来源:Justin McCarthy,2026-02-06
图:StrongDM 官方公布的场景构建界面。团队将验收场景作为验证生成软件的重要依据。图片来源
这项实验探索了一条新的信任路径:减少人工阅读实现,增加对验证环境的投入。
代码可以退到幕后,但幕后需要一套相当复杂的工程设施。原先由审查者承担的判断,必须在其他地方得到承接。
这里仍然存在一个问题:验收依据,真的能在实现之前就被完整写出来吗?
Fowler 的反问:你真的已经知道自己要什么了吗?
Martin Fowler 和 Unmesh Joshi 在讨论 LLM 与抽象设计时,区分了两种工作:使用已经存在的抽象,以及创造新的抽象。
搭建一个熟悉的服务,模型可以迅速提供实现。但业务概念还不清楚、职责边界还在变化,编程本身也是探索。
Joshi 在对话中说:
“The very act of ‘writing code’ is often where design decisions crystallize.”
许多设计决策,恰恰是在写代码的过程中逐渐成形的。来源:Unmesh Joshi 与 Martin Fowler,2025-08-26
例如,我们可能最初认为“订单取消”只是修改一个状态。真正开始实现后,才发现它涉及库存释放、支付撤销,还涉及履约中断,以及不同时间点的不同权限。
实现让需求中的含糊变得无法回避。
如果把需求和实现彻底分开,就可能削弱这条反馈路径。我们通过尝试实现,才逐渐理解问题;新发现又会改变需求和设计。
Fowler、Joshi 与 Rebecca Parsons 后来的讨论继续强调了这种关系:“做什么”与“怎么做”需要相互修正。来源:LLMs and the what/how loop,2026-01-21
AI 可以参与甚至加速这个过程。但这与“需求已经确定,剩下只有生成”是两种不同的开发情境。
对尚未想清楚的问题,设计仍然承担着帮助人理解业务的工作。
Simon Willison:代理越能干,人越需要工程经验
Simon Willison 积极使用 AI 编程,同时区分了低风险实验与需要长期维护的软件。
前者可以让模型生成,看到结果能用便接受。后者要求工程师持续承担质量责任。
他在《Vibe engineering》中写道:
“AI tools amplify existing expertise.”
AI 工具会放大已有的专业能力。
在他的实践里,测试与规划、文档与版本控制,以及代码审查和人工验证,都能帮助代理取得更好的结果。他也强调,软件工程师需要判断哪些工作适合交给 AI,哪些仍需要自己处理。来源:Simon Willison,2025-10-07
这解释了为什么今天的开发者仍然频繁阅读产物代码。
产出速度提高,不会自动提高我们对产出的理解。一个实现可能满足眼前的示例,却遗漏隐含约束;测试也可能沿用了生成代码时的同一个错误理解。
阅读代码能够补充行为测试没有提供的信息。当然,人工审查本身也会遗漏问题。工程判断需要多种证据,不能仅凭某一种检查通过就结束。
“少写代码”已经成为现实,“可以少理解多少”仍然取决于任务。
最直接的反对意见:AI 也会被坏结构拖累
Thoughtworks 杰出工程师 Birgitta Böckeler 提出了更具体的观察。
她在 2026 年 5 月的文章中指出:
“Internal quality problems affect AI agents in similar ways that they affect human developers.”
内部质量问题会以类似影响人类开发者的方式,影响 AI 代理。
结构纠缠时,代理可能找错实现位置,忽略重复逻辑,或者为了完成一个小任务而加载过量上下文。她因此尝试用依赖规则和耦合指标,结合模块化审查与回归验证,持续监测代码的可维护性。来源:Birgitta Böckeler,2026-05-27
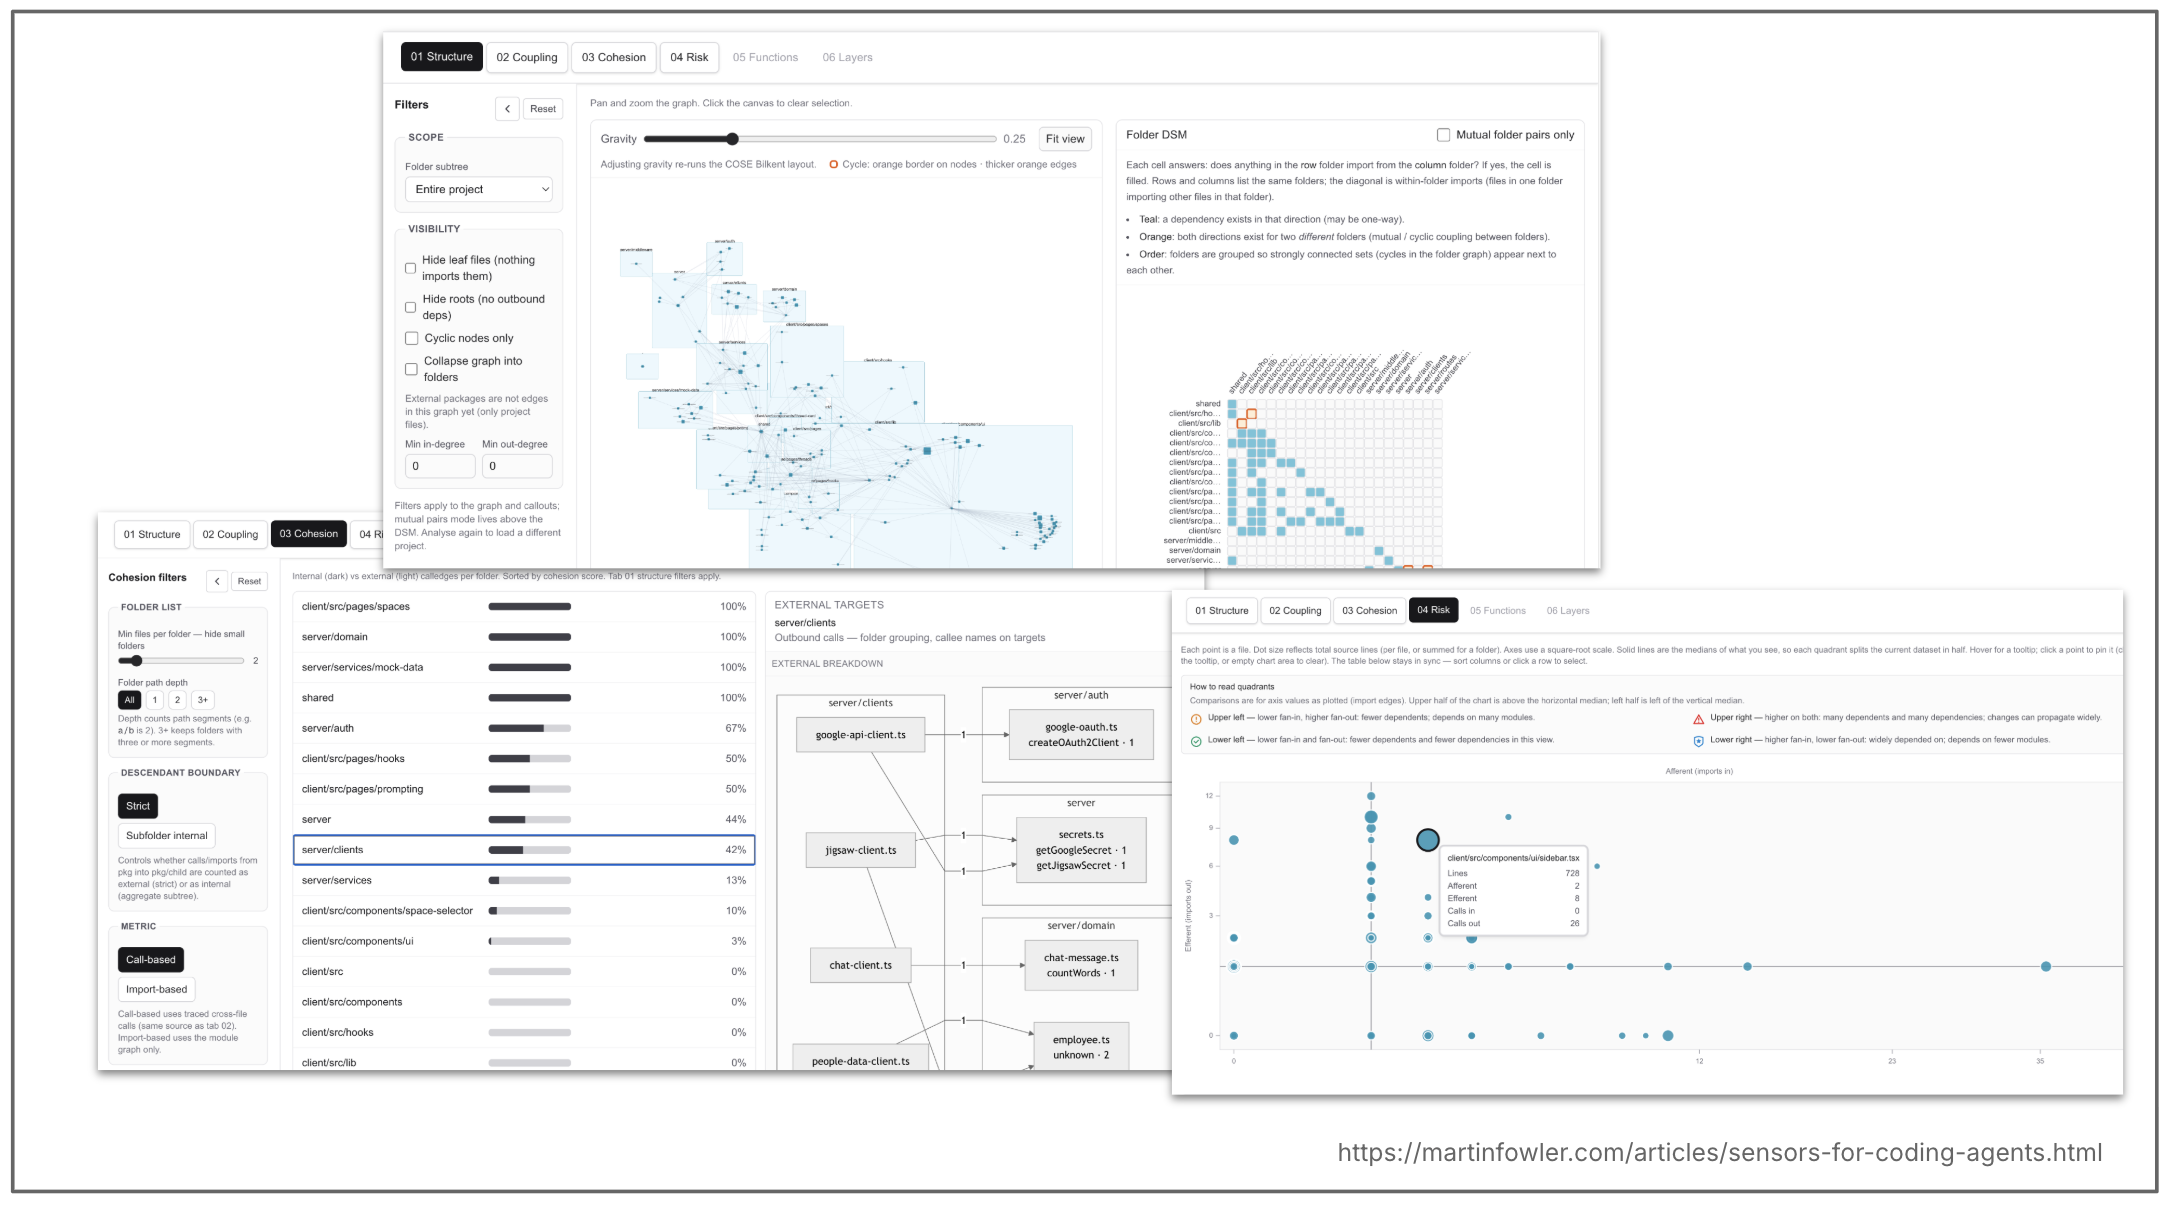
图:Böckeler 实践中的代码耦合监测看板,用于观察代码关联,辅助判断修改的影响范围。图片来源
这直接挑战了“机器维护代码,所以结构不再重要”的推论。
代理也需要定位信息、控制上下文,并判断修改范围。职责清楚的模块能缩小任务边界,散落各处的重复实现则要求它每次都找到全部关联位置。
因此,有些结构约束可能同时服务于人和 AI。模块边界是否合理、依赖是否清楚,都会影响修改过程。
把这些约束交给自动化检查,并不会消除它们的价值。执行者变了,约束仍然在发挥作用。
代码退到幕后,设计会去哪里?
这些观点的分歧,涉及不同的自动化目标和软件开发场景。
Shapiro 与 McCarthy 探索人可以退出多少实现工作。Fowler、Willison 和 Böckeler 则提醒我们,软件演化仍然需要发现问题、控制变化,并持续建立可信的验证依据。
我们不能仅凭生成成本下降,就认定内部结构必然失去价值。重新生成一份代码,还需要证明它保留了必要行为,能够接替旧系统,并承受下一轮变化。
反过来,也没有必要把过去的每条设计惯例都当作永久规则。有些抽象主要为了减少人工重复劳动,有些规范主要照顾人的阅读习惯。AI 改变了成本之后,这些投入确实值得重新评估。
更有用的判断方式是追问:这项设计究竟降低了什么成本?它让需求更清楚,让修改更局部,还是让错误更容易被发现?
如果它持续发挥这些作用,就仍然值得保留。
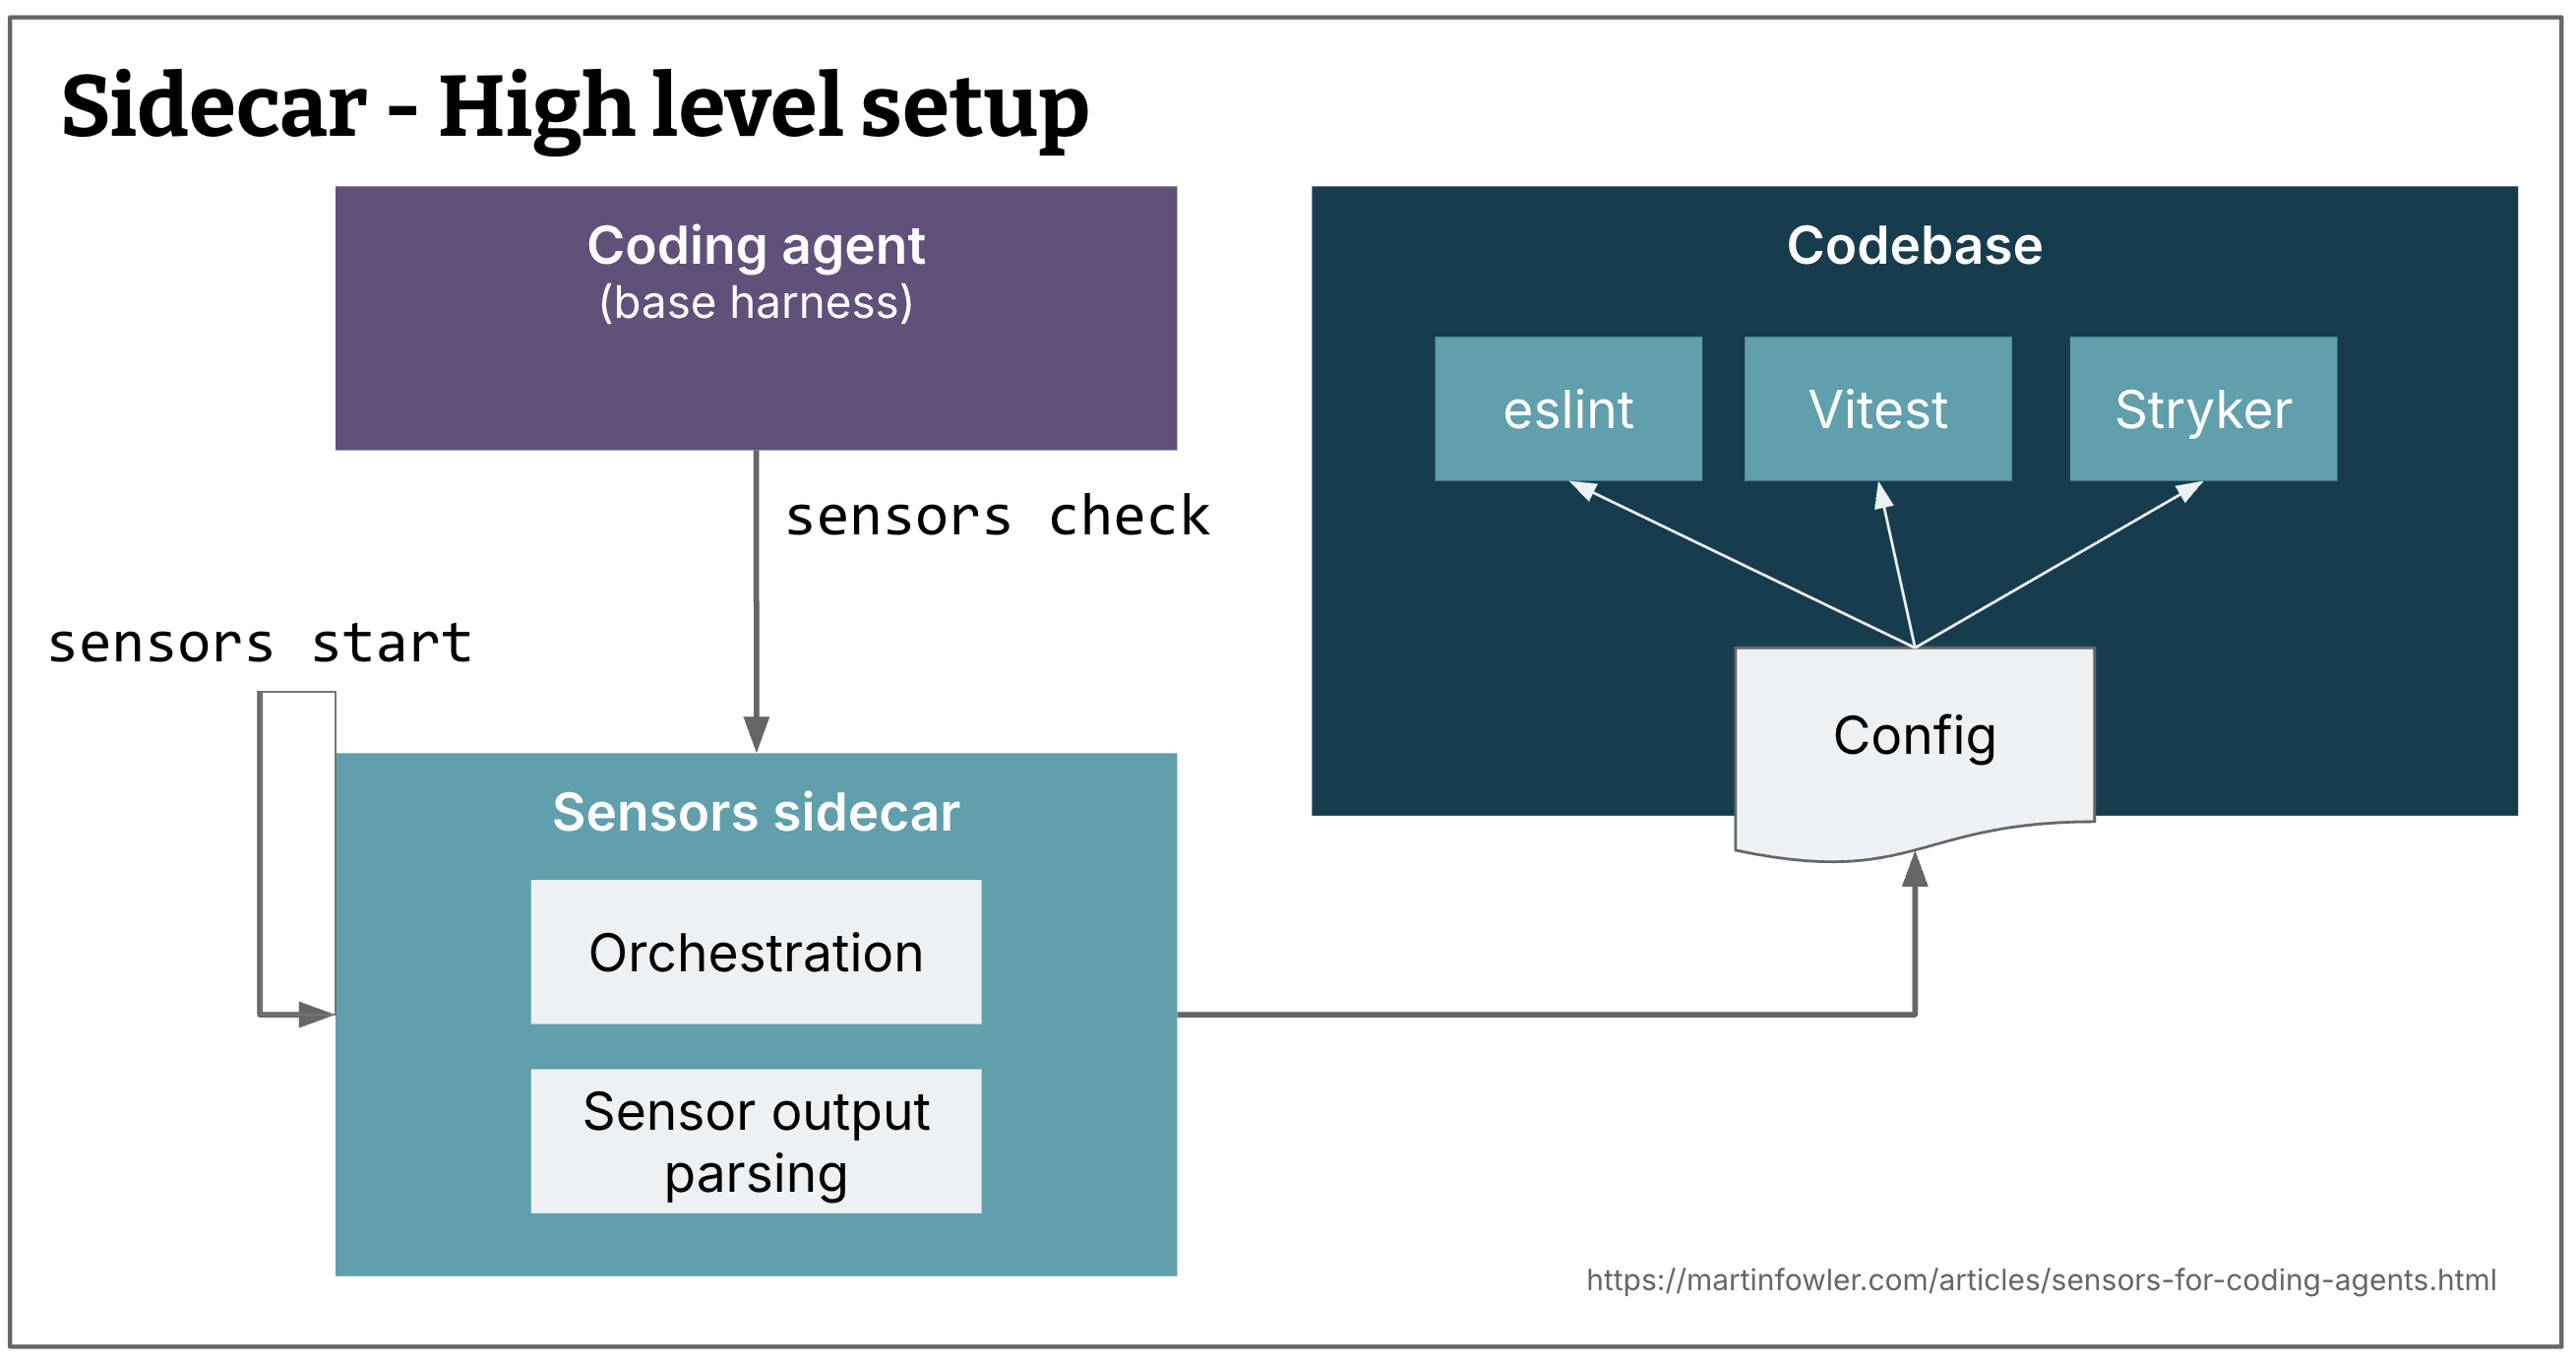
图:编码代理通过独立监测组件获取代码库的检查结果。质量反馈可以逐步自动化;这张架构图本身并不能证明人工理解已经多余。图片来源
我的判断是,开发者会越来越少地亲手处理局部实现,也会有更多任务可以主要依靠结果验收。但程序设计的价值,仍要看它是否帮助系统可靠地变化。
优雅也需要接受这个检验。
一个抽象即使漂亮,如果增加了修改负担,就值得拆掉。一段代码即使由机器生成,只要边界清楚、行为容易验证,也可能具备很好的工程质量。
开发者未来可能不必熟悉每一个函数,却仍然需要知道:哪些约束不能破坏,哪些证据足以支持交付,以及什么时候应该重新进入代码,检查工具没有解释清楚的部分。
代码可以逐渐退出日常视野。让软件保持可理解、可验证、可修改,仍然需要设计。
评论