不懂 AI,也能看懂 Transformer:从一张“信息卡”说起
你可以把 Transformer 想成一个“反复读上下文,再接着写”的文字处理系统。它是许多大语言模型内部组织计算的方式。
听起来有点抽象。我们先看一句日常的话:
小明把外套借给小红,因为她觉得冷。
你读到“她”,会联系前文,推测这里说的是小红。你不需要停下来分析语法,也能把分散在句子里的信息联系起来。
Transformer 的核心能力之一,就是处理一段文字时,让不同位置的信息建立联系。
我们沿着这句话走一遍。不需要公式,也不用先学编程,就能看懂它的大致结构。下面主要讨论生成文字的 LLM 中常见的 Decoder-only Transformer;“信息卡”和“读者”都是帮助理解计算过程的比喻。
第一步:把文字变成一张张“信息卡”
计算机不能直接拿汉字做神经网络计算,所以第一件事,是把文字转换成数字。
模型会先把文字切成小块,叫作 token。一个小块可能是一个字、一个词,也可能只是词的一部分。具体怎么切,取决于模型使用的分词器,并不总是按日常理解的词语切分。
随后,每个小块会变成一串数字。你可以把这串数字理解成一张可以不断修改的“信息卡”。
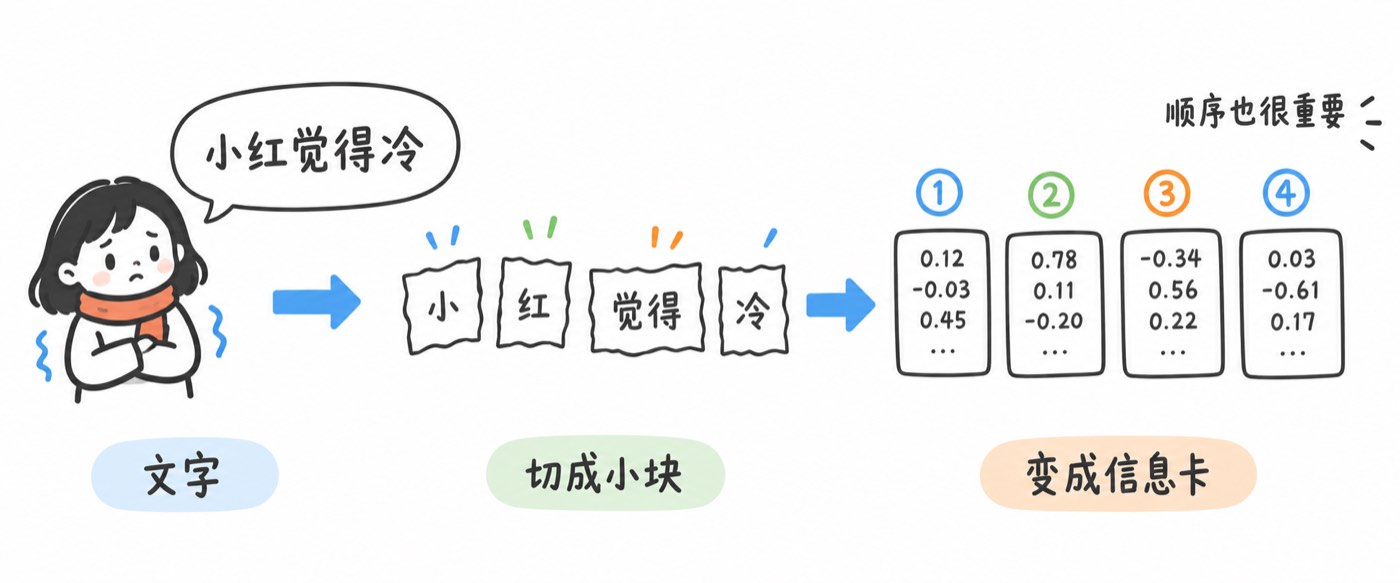
卡片上的数字不是人手写进去的中文解释,而是模型能计算和加工的表示。模型经过训练,学会如何使用这些表示。
只有卡片还不够,系统还需要知道它们的顺序。比较下面两句话:
小明帮助小红。
小红帮助小明。
用词相同,意思却不同。因此,Transformer 还需要位置信息,帮助它区分谁在前、谁在后。不同模型加入位置信息的方式有所不同,我们暂时把它理解成“系统知道卡片的排列顺序”就够了。
第二步:每张卡片,都去参考相关的上下文
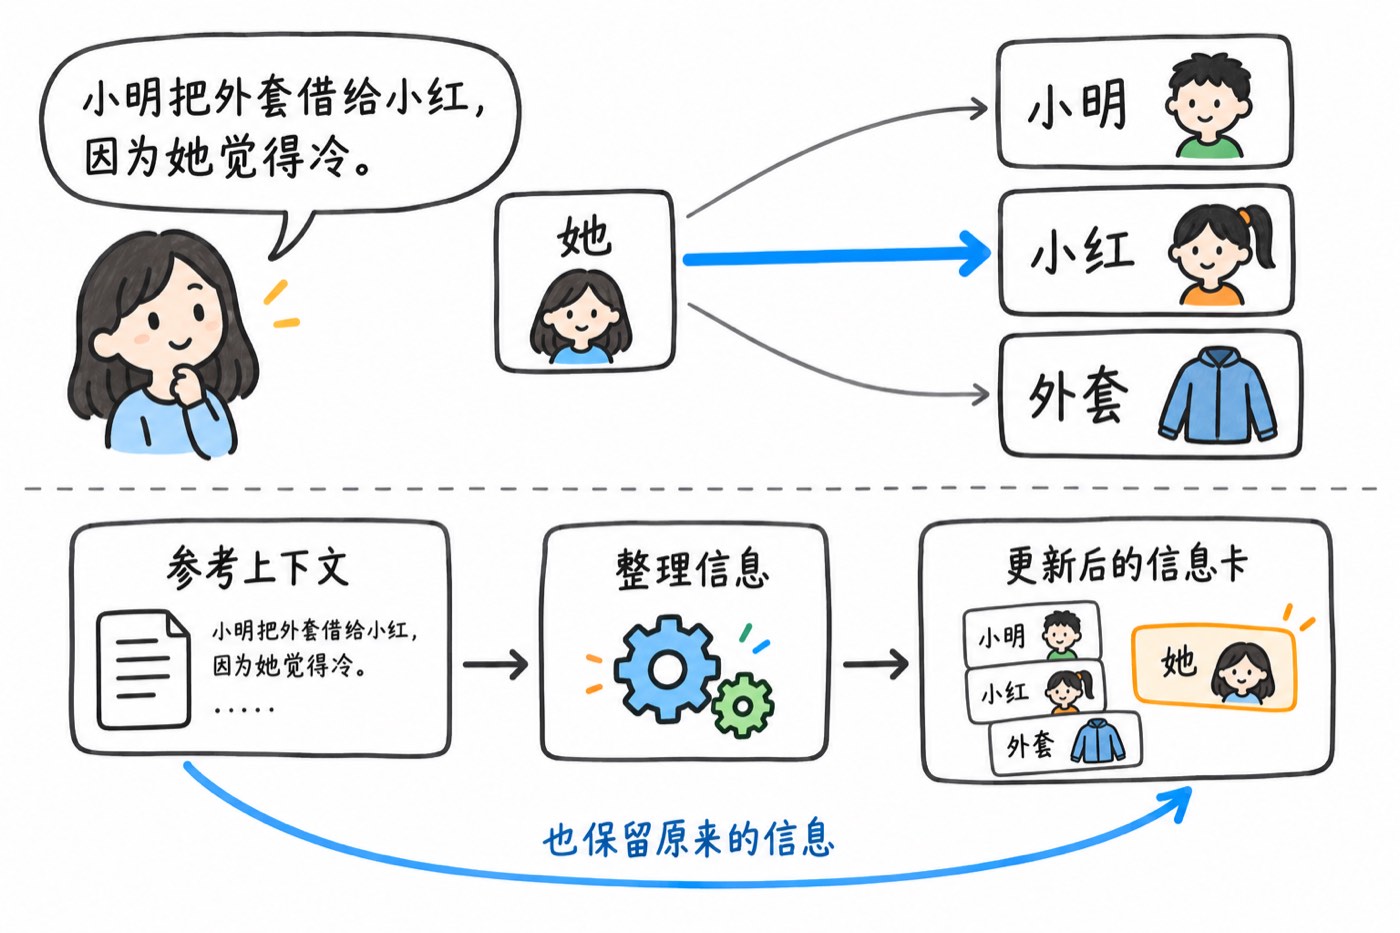
现在,模型读到了“她”。单看这个字,还不知道它指的是谁,需要参考前面出现过的信息。
模型会计算:哪些位置的信息,值得在这里多参考一点?
“小明”“小红”“外套”等上下文都会参与计算,只是影响大小不同。这个给不同信息分配参考权重的机制,叫作 注意力。
这里的“注意力”并不是模型有意识地盯着某个词看,而是一组数字计算。相关信息可以通过这些计算,汇入“她”所在位置的信息卡。
你还可能听过一个更长的名字:多头注意力。
可以把它想成几组读者同时阅读:各自寻找不同的联系,最后把结果汇总起来。这样,模型就不必只用一种方式参考上下文。
不过,这些“读者”没有预先安排好的固定岗位。并不是一组专门看语法,另一组专门找人名。不同的关联方式,是在训练中逐渐学出来的。
还有一个重要限制:我们这里讨论的生成式模型,在处理某个位置时,只能参考这个位置以及前面的内容,不能偷看后面的文字。就像接龙时,你只能根据已经出现的内容往下接。
第三步:把收集来的信息,再整理一遍
参考完上下文,并不意味着这一轮处理就结束了。
模型还会进一步加工每张信息卡,把刚刚汇总的信息进行组合和变换。负责这部分工作的组件,叫作 前馈网络。
两个组件可以这样区分:
| 组件 | 用日常语言理解 |
|---|---|
| 注意力 | 参考其他位置的信息 |
| 前馈网络 | 加工当前这个位置的信息 |
注意力让卡片之间产生联系,前馈网络则继续处理已经收集到的信息。两者配合,完成一轮更新。
在这个过程中,模型通常还会保留加工前的信息,把新结果加回原来的表示,而不是每次全部覆盖。这条保留原信息的通路,叫作 残差连接。
你可以把它想成:在原笔记上补充内容,而不是每读一遍就把笔记全部擦掉。这个比喻并不意味着模型真的保存着一份可以阅读的笔记,但能帮助我们理解为什么图中会有一条绕过加工步骤的旁路。
此外,层内还会用到“归一化”,帮助控制数字的尺度,使训练更稳定。它属于让计算顺利进行的基础环节,第一次理解架构时,不必深究它的公式。
第四步:把这样的处理,重复很多轮
到这里,我们已经看懂一层 Transformer 的主要工作:参考上下文,然后加工信息。
实际模型会把很多层叠起来。第一层处理后的卡片,交给第二层;第二层的结果,再交给第三层。每一层通常有自己的一组参数。
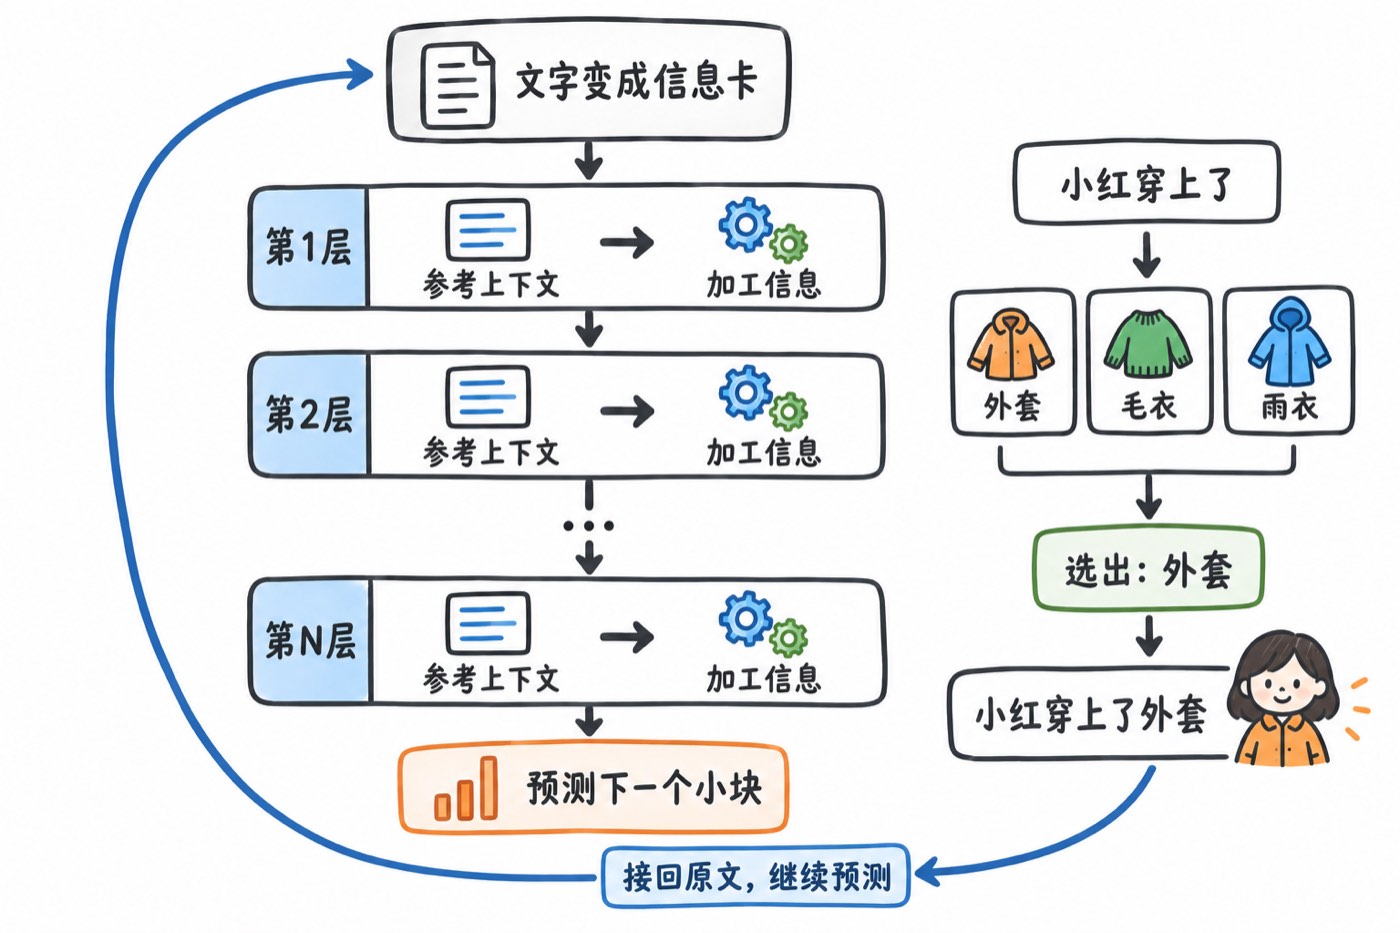
随着处理不断进行,每张卡片就不再只是最初那个字或词的表示,还混入了从上下文获得的信息。
例如,“她”最初只是一个代词。经过多轮计算后,它所在位置的表示,可以包含与人物和句子内容有关的信息。这能帮助模型判断接下来怎样写比较合适。
这里不要把每一层想成一道固定的人工作业:第一层认字、第二层学语法、第三层理解感情。模型的实际计算并没有这么整齐,每一层也未必能对应一个清楚命名的任务。
你只需要抓住一件事:许多轮“参考上下文、加工信息”,让模型得到更适合后续预测的表示。
第五步:利用处理结果,接着写一个小块
假设你输入:
小红觉得冷,于是穿上了
经过前面的多层处理,模型会把最后一个位置的信息,转换成下一个 token 的概率。模型的词表里有许多候选项,不同候选项的概率不同。
为了方便理解,我们用完整词语来举例:接下来可能是“外套”,也可能是“毛衣”。真实计算的单位仍然是 token,所以一个完整词语未必一次就生成完。
模型按照生成规则选出一个 token,把它接回已有文字,再预测下一个:
小红觉得冷,于是穿上了……
小红觉得冷,于是穿上了外……
小红觉得冷,于是穿上了外套……
这里的逐字展开只是示意,并不代表某个具体模型一定如此分词。
一段看起来完整流畅的回答,就是这样一点点生成出来的。模型也不一定每次都选概率最高的候选项;生成设置会影响它如何选择。
从概念上说,每生成一个新 token,就再做一次预测。实际系统通常会缓存之前算过的一些结果,因此并不需要每一步都把所有历史计算从头重做。
它为什么知道该参考什么、该怎么接?
Transformer 描述的是计算结构,但光有结构,还不会说话。
这些能力主要来自训练。模型看过大量文本,反复进行预测,再根据预测误差调整内部参数。随着训练推进,它逐渐学到词语、句式、知识和上下文之间的复杂关系。
可以把两件事分开看:
- 训练时:不断预测和纠错,调整内部参数。
- 聊天时:使用已经学好的参数,根据当前上下文生成内容。
聊天中的新信息可以影响当前回答,但这通常不等于模型每回答一次,就重新训练了一遍。
看懂架构后,再回头看“理解”这件事
现在,你已经能沿着一条完整的路线解释 Transformer:
文字先变成数字信息卡;每张卡片参考相关上下文,再加工自己的信息;这样的处理重复很多层;最后,模型利用处理结果,预测接下来该出现什么。
这套机制能够产生很强的语言能力,但输出流畅,并不意味着内容一定正确。模型可能判断错指代,也可能把不可靠的信息写得像真的一样。
文中的“信息卡”“读者”和“整理笔记”,都是把数字计算说得直观一些的比喻。Transformer 并没有像人一样在脑海中读句子,但借助这几个比喻,我们已经可以看懂它最重要的结构,以及这些结构如何一起完成生成文字的工作。
评论