DeepSeek-V4.1-Flash:把百万 Token 的记忆,压缩成一套分级缓存
如果把大模型看成一个读书的人,过去的做法是:每读一页,每个思考层级都各抄一份笔记。DeepSeek-V4.1-Flash 的做法则是:旧资料只整理几次,多个层共享笔记;查资料时先缩小范围;每一层只提出自己的问题。
长上下文模型最容易让人产生一个误解:只要模型“支持 100 万 Token”,就意味着它能轻松处理 100 万 Token。
事实上,能装下和能高效使用,是两件完全不同的事。上下文越长,大模型不但要付出更多计算,还要保存、搬运和持久化越来越庞大的 KV Cache。对会反复调用搜索、代码执行和数据库的 Agent 来说,这个问题尤其严重。
DeepSeek-V4.1-Flash 的核心贡献,不只是把 KV Cache 换成更低精度的 FP4,而是重新安排了三件事的更新频率:
- 内容(Content):历史中有什么可以读取;
- 地址(Address):这一次应该读取哪些位置;
- 查询(Query):从选中的内容中,应该怎样读。
昂贵的内容更新得最慢,地址偶尔更新,便宜的 Query 每层更新。围绕这个原则,CED、CSA2、HSI 和 FP4 才组成了一套完整的系统。
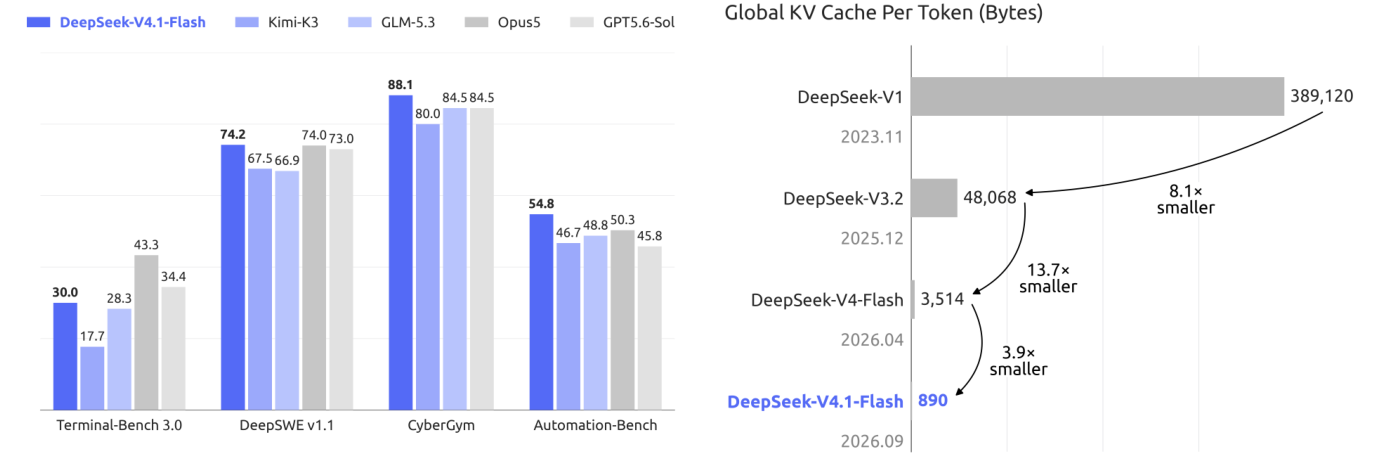
图 1:DeepSeek-V4.1-Flash 在原文列出的 Agent 基准上保持较好表现,同时把全局 KV Cache 从 V4-Flash 的 3514 B/Token 降至 890 B/Token。图片引自参考文章。
一、问题不是“记不住”,而是“笔记太多”
1. 大模型怎样阅读一句话
一句话进入 Transformer 后,会被切成 Token。每一层都会把当前表示投影成三类向量:
可以把它们理解为:
- Q:我现在想找什么;
- K:每条历史信息的索引标签;
- V:找到以后真正取出的内容。
标准注意力的核心计算是:
生成文本时,过去 Token 的 K 和 V 不会随着新 Token 到来而改变,因此可以缓存下来,不必每生成一个字都重算。这就是 KV Cache。
它像一本书的索引卡:卡片能避免反复阅读全文,但卡片本身也需要地方保存。上下文长度、模型层数和每条缓存的宽度相乘后,规模很快就会失控。
2. Prefill 和 Decode 是两种不同的工作
大模型推理可以粗略分成两个阶段:
- Prefill:阅读用户输入和历史记录,一次处理许多 Token,并建立 KV Cache;
- Decode:一次生成一个新 Token,并不断查询已有缓存。
在普通问答里,Prefill 通常只发生一次。但 Agent 会调用工具,工具结果又会成为下一轮输入,于是流程变成:
阅读历史 → 调工具 → 加入结果 → 再阅读新增内容 → 再调工具。
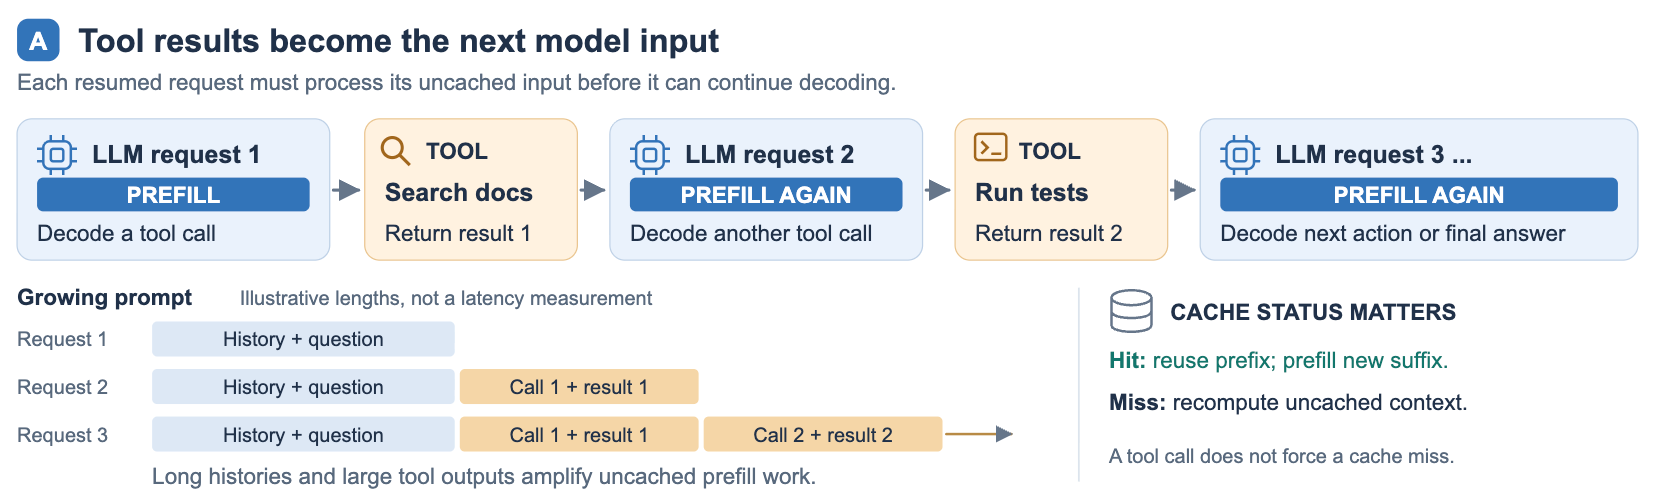
图 2:工具结果不断追加到上下文。命中前缀缓存时只需处理新增后缀;缓存未命中时,长历史会放大 Prefill 成本。图片引自参考文章。
问题在于:Agent 的历史可能已经很长,而一轮新增内容可能只有几十或几百个 Token。如果每次都让全部网络重新处理大量历史,计算和数据搬运就会压过真正的推理工作。
二、CED:让长 Prompt 只走半程
DeepSeek-V4.1-Flash 有 40 层主干。CED(Causal Encoder-Decoder)把它们分成两半:
- 前 20 层是 Causal Encoder,负责整理上下文;
- 后 20 层是 Decoder,负责继续推理和生成。
关键变化是:Decoder 的全局 KV 不再由每个 Decoder 层分别从自己的隐藏状态生成,而是从 Encoder 的最终表示投影而来。于是,大部分长 Prompt 只需要经过前 20 层;后 20 层使用自己的 Query,反复读取 Encoder 已经整理好的全局记忆。
如果输入长度为 L、Encoder 和 Decoder 深度分别为 N_e、N_d,Decoder 只重放末尾 R 个 Token,那么 Prefill 主体工作量可以粗略写成:
传统 40 层全部处理的工作量是:
当 L \gg R 且 N_e=N_d=20 时:
这就是“Prefill 接近减半”的来源。它不是所有场景都严格加速 2 倍,因为还有投影、索引、通信以及尾部重放等开销。
为什么还要重放尾部
模型除了全局记忆,还保留一个 128 Token 的滑动窗口注意力(SWA),用来精读最近内容。Decoder 的每一层都需要自己的局部 KV;但长 Prompt 的大部分位置没有经过 Decoder,自然也没有留下这些局部缓存。
理论上,要精确恢复深层 SWA 状态,需要不断向更早位置追溯。层数越深,追溯范围越大。这可能把 CED 省下的计算重新花掉。
因此 DeepSeek 使用 Bounded Replay:只让 Prompt 尾部一个固定范围通过 Decoder,不追求对全部局部状态的精确重建。代价是尾部局部状态带有近似,但全局历史仍可通过共享 KV 访问。
这是一种非常工程化的取舍:不追求数学上的完全复现,而是把每轮 Agent 调用的状态恢复成本控制在一个上限内。
三、CSA2:同时压缩通道、序列和层
CED 主要减少 Prefill 计算。真正把 KV Cache 压到 890 B/Token 的核心是 CSA2。
CSA2 沿三个可以相乘的维度压缩缓存:
| 维度 | 做法 | 直觉 |
|---|---|---|
| 通道 | 多个注意力头共享 512 维 Main KV latent | 多位老师共用一套资料摘要 |
| 序列 | Encoder 将相邻两个位置压成一个缓存条目 | 两页内容合并成一张索引卡 |
| 层 | 多层共享 Main KV、Indexer K 和部分 Top-K 结果 | 多层不再各抄一份相似笔记 |
三者不是互相替代,而是相乘:每条记录更小、记录数量更少、独立副本也更少。
Full、Reindex、Reuse 三种模式
跨层共享不能简单理解为“后面所有层都照抄上一层”。CSA2 把刷新操作拆成三档:
| 模式 | Main KV 内容 | 检索地址 Top-K | 当前层 Query | 成本 |
|---|---|---|---|---|
| Full | 重新生成 | 全范围重新检索 | 重新生成 | 最高 |
| Reindex | 复用 | 在候选池内重新检索 | 重新生成 | 中等 |
| Reuse | 复用 | 直接复用 | 重新生成 | 最低 |
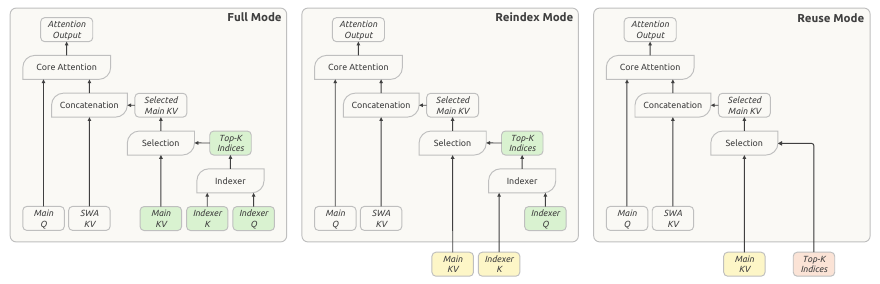
图 3:绿色表示当前层生成,黄色表示复用 Main KV 或 Indexer K,红色表示复用 Top-K 地址。图片引自参考文章。
可以把三种模式类比成查图书馆:
- Full:重新整理书架、重做目录、重新查书;
- Reindex:书架不动,但重新查目录;
- Reuse:书架和书单都不动,只换一个阅读问题。
Encoder 中,每个 6 层宏块由 1 层 Full 加 5 层 Reuse 组成。Decoder 则先用 1 个 Full 块建立共享内容和候选池,再用多个 Reindex 块周期性更新地址,其余层使用 Reuse。
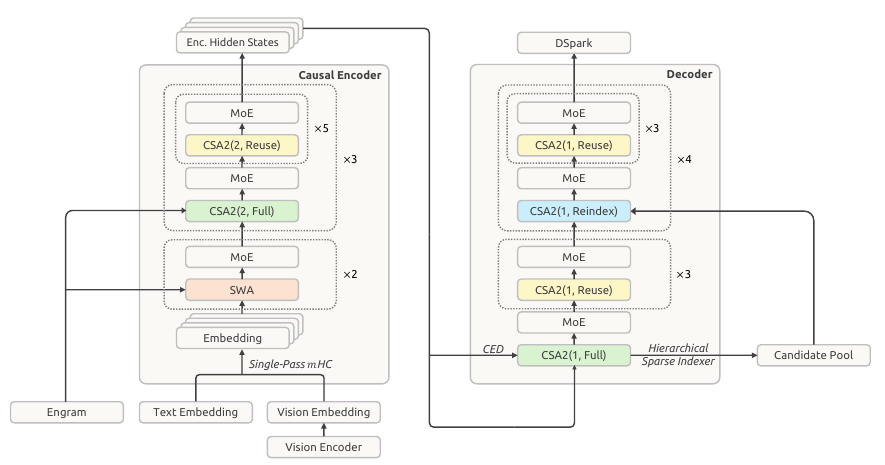
图 4:前半部分 Causal Encoder 生成可共享的表示,后半部分 Decoder 通过 Full、Reindex 和 Reuse 不同频率刷新状态。图片引自参考文章。
四、为什么 KV 不变,每层仍能做不同的事
这是整套设计最值得深入理解的地方。
对一次稀疏注意力读取,可以把三个变量分开:
- 内容集合 C=\{c_j\}:有哪些信息可以读取;
- 地址集合 A:本次允许读取哪些位置;
- 查询 q:如何给这些位置分配权重。
在固定内容和地址时,输出为:
虽然 c_j 和 A 不变,但每层都可以生成不同的 q,所以权重 p_j(q) 仍会改变。同一组资料,历史老师、地理老师和语文老师提出不同问题,得到的阅读重点也不同。
Query 重写其实是在重新倾斜概率分布
设发布地址的源层查询为 q_0,某个 Reuse 层使用:
对应的新权重可以写成:
也就是说,Reuse 层不是重新搜索,而是在原有分布上做一次指数倾斜:提高某些内容的权重、降低另一些内容的权重,然后重新归一化。
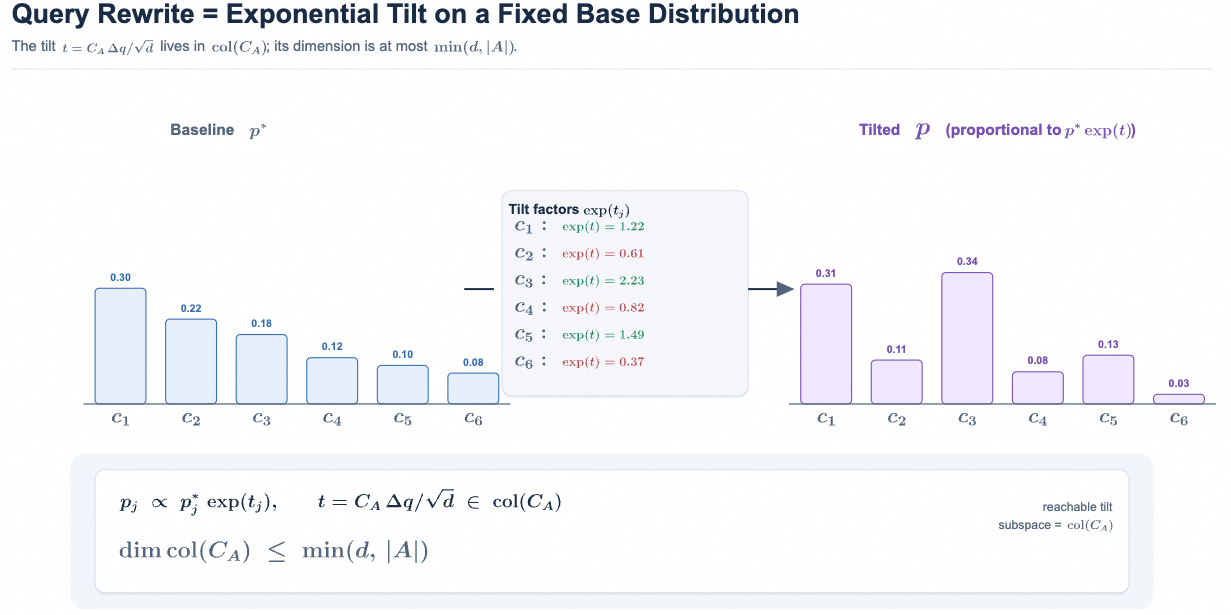
图 5:内容和候选位置保持不变,仅改变 Query,也能明显改变最终注意力分布。图片引自参考文章。
这种能力很强,但并非没有边界。因为权重非负且总和为 1,输出总是在被选中内容向量的凸包内:
于是 Reuse 有三个无法绕过的限制:
- 召回上限:上游 Top-K 没选中的内容,下游再聪明也读不到;
- 内容上限:输出无法跳出固定内容形成的表示范围;
- 几何上限:固定内容决定了 Query 能怎样改变权重。
这正是 Full 和 Reindex 仍然存在的原因。Reuse 负责低成本精读;Reindex 偶尔换书单;Full 更低频地重建整套内容。三者共同组成“内容慢、地址中等、查询快”的刷新节奏。
五、HSI:先选书架,再找具体页面
即使缓存被共享,如果每个需要重新索引的层都扫描 100 万个位置,计算仍会很昂贵。
HSI(Hierarchical Sparse Indexer)采用两级检索:
- Decoder 的第一个 Full 层扫描完整历史;
- 每 8 个位置组成一个块;
- 根据块内最高分,选出最多 2048 个块;
- 形成最多 2048\times8=16384 个位置的候选池;
- 后续 Reindex 层只在候选池内选择自己的 Top-512。
这像先从整座图书馆选出相关书架,再让不同老师从这些书架中各自挑书。第一个 Full 层的成本仍随上下文长度增长,但后续 Reindex 的搜索范围被固定在最多 16384 个位置,因而不再随百万级上下文同步膨胀。
技术报告强调,HSI 在后训练阶段以训练感知方式引入:训练和推理都使用相同候选限制,避免模型训练时能搜索全历史、上线后却突然只能看候选池。
至于具体使用了怎样的 Indexer 辅助损失,公开报告没有披露。参考文章给出的混合损失形式属于作者推测,不应当作成官方实现。
六、890 B/Token 是怎样算出来的
DeepSeek-V4.1-Flash 的全局缓存包含两部分:
- Main KV:512 维内容向量;
- Indexer K:128 维检索键。
二者均以 FP4 保存,但 scale 元数据的分组方式不同。根据参考实现中的布局:
- 一个 Main KV 条目约为 288 字节;
- 一个 Indexer K 条目约为 68 字节。
因此,一整份全局缓存条目为:
Encoder 只有 3 个 Full 源层保存长期缓存,而且序列压缩比为 2,即每两个 Token 一个条目:
Decoder 只有 1 个 Full 源层保存长期缓存,但为了保留逐 Token 寻址,压缩比为 1:
总计:
V4-Flash 约为 3514 B/Token,因此:
也就是接近 4 倍压缩。对于 100 万 Token,仅按这里计算的全局 KV:
- V4-Flash:约 3.514 GB;
- V4.1-Flash:约 0.890 GB。
需要强调:这不是运行整个 552B 参数模型所需的总显存,只是文章口径下的全局 KV Cache;模型权重、激活、SWA 局部缓存、运行时工作区和系统开销都不包含在内。
真正贡献最大的是哪一步
一个容易被标题吸引而忽略的事实是:FP4 不是最大贡献者,跨层复用才是。
参考文章给出的分解是:
| 阶段 | 全局 KV,B/Token |
|---|---|
| V4-Flash,各层独立保存 | 3514 |
| 先应用跨层复用,仍沿用旧格式和压缩率 | 652 |
| 为提升表达能力,放宽序列压缩率 | 1630 |
| 再使用 FP4 Main KV | 890 |
也就是说,DeepSeek 先通过层间共享节省大量副本,再“花回”一部分空间,把 Encoder 压缩率从 4:1 放宽到 2:1、Decoder 放宽到 1:1,以换取更细粒度的寻址;最后用 FP4 把空间重新压下去。
这不是一味追求最小缓存,而是在容量、检索精度和计算成本之间重新分配预算。
七、其他模块怎样配合主线
FP4 Main KV
Main KV 使用 E2M1 数据,并按通道组共享 E4M3 scale。它在真正执行注意力前会被反量化到更高精度,所以 FP4 的主要目标是减少 HBM、主机内存和 SSD 中的存储与搬运,而不是依赖硬件直接进行 FP4 矩阵乘法。
SWA 局部 KV 对量化更敏感,因此保留 FP8。这再次体现了同一个原则:不同状态不必使用相同的精度和更新策略。
Engram
Engram 像一个巨大的短语记忆表,根据 2-gram、3-gram 和 4-gram 确定性寻址。常见短语和局部组合可以直接查表,不必全部通过计算生成。其参数可放在主机内存,并借助可预测地址提前取回。
MoE
模型拥有 384 个路由专家,但每个 Token 只激活 6 个。这样可以扩大知识容量,而不让每次计算都承担全部参数成本。图像和文本 Token 使用各自的专家负载校正偏置,避免两种模态互相掩盖负载不均。
DSpark
DSpark 是推测解码模块。它用三个轻量块并行提出多个后续 Token 候选,再由主模型验证。它不减少 KV 本身,但能减少主模型逐 Token 前进的次数,提高 Decode 吞吐。
多模态视觉分支
图片先由 32 层 ViT 编码,再把相邻 3\times3 的视觉特征合并为更宽的向量,使视觉 Token 数量约降为原来的九分之一,随后投影到语言模型的 5120 维空间。单图视觉 Token 预算约为 1024。
八、从“模型结构”到“计算机系统”
如果只从神经网络公式看,CSA2 像是几种注意力变体的组合;从计算机体系结构看,它的逻辑反而更清楚:
| 大模型中的对象 | 计算机中的类比 | 刷新频率 |
|---|---|---|
| Query | 寄存器中的当前操作数 | 每层刷新 |
| Top-K 地址 | 地址生成结果或 TLB 条目 | 中频刷新 |
| Main KV | 多层共享缓存 | 低频刷新 |
| MoE / FFN | 大容量后端存储与变换 | 每层使用不同参数 |
Full 像缓存未命中后的填充;Reindex 像数据仍在缓存中,但重新做地址翻译;Reuse 则像数据和地址全部命中,只需要换当前操作数执行读取。
这是 DeepSeek-V4.1-Flash 最重要的架构思想:
不要让所有状态以最昂贵的频率更新。根据状态变化速度和重算成本,建立不同的缓存层级。
这一思想也解释了为什么它更像“递归 Transformer”。在一个由 1 层 Full 和若干 Reuse 组成的宏块中,长期内容保持不变,各层通过新的 Query、局部 SWA 和不同 MoE,反复加工同一份共享记忆。
九、它解决了什么,又没有解决什么
它解决的
- 长上下文缓存太大:通过通道、序列、层和精度四方面共同压缩;
- Agent 反复 Prefill 太贵:多数历史只通过前 20 层;
- 稀疏检索仍随上下文增长:后续 Reindex 被限制在固定候选池;
- 缓存搬运成为瓶颈:890 B/Token 同时降低 HBM、主机内存、SSD 和互联压力。
它没有免费解决的
- Reuse 无法修复错误召回:候选集合漏掉的信息,改变 Query 也找不回来;
- Bounded Replay 是近似恢复:它用固定开销换取了非精确的局部状态;
- 第一层全局检索仍随上下文增长:HSI 主要把后续检索变成固定成本;
- 系统复杂度更高:缓存来源、重放、候选池、量化格式和跨设备搬运都需要推理框架配合;
- 部分训练细节未公开:尤其是 HSI 后训练损失和某些索引器训练机制。
结语:真正的突破是“分级更新”
用一句大白话总结 DeepSeek-V4.1-Flash:
旧资料只整理几次,索引偶尔重做,每一层只提出自己的新问题。
CED 让长 Prompt 不必走完 40 层;CSA2 让多个层共享内容和索引;HSI 把百万级搜索缩小到固定候选池;FP4 再把每条缓存压得更小。Engram、MoE、DSpark 和视觉压缩则分别从知识存储、参数激活、生成速度和多模态输入上补齐系统。
因此,890 B/Token 不是某个孤立技巧创造的数字,而是一整套“计算、存储、寻址和精度分层”的结果。
对长上下文模型而言,下一阶段的竞争可能不再只是“参数更多、窗口更长”,而是谁能更聪明地回答三个问题:什么必须长期保存,什么可以低频更新,什么只需在当前一步重新计算。
参考资料与说明
- Zartbot,DeepSeek-V4.1 Flash: Pushing the Limits of KV Cache Compression。本文的主要架构解读、参数表、图片和 890 B/Token 推导均参考该文。
- DeepSeek,DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression 技术报告。
- Sun et al.,You Only Cache Once: Decoder-Decoder Architectures for Language Models。CED 的关键思想继承自 YOCO。
评论