图解大模型间通信:从“文本交换”到“缓存转换”
当一个模型已经读懂了输入,另一个模型能否直接利用它的中间计算结果?Cache-to-Cache 将大模型协作的接口,从文字推进到了内部表示,也把一组新的工程问题带到了台前。
在一个多模型系统里,协作往往从一段文字开始。
负责代码分析的模型读完仓库,写出问题定位;负责实现的模型接收说明,修改代码;负责检查的模型再读一遍改动,给出审查意见。我们通过提示词分配角色,通过消息组织流程,最终搭起一个看起来分工明确的团队。
这套架构很自然。人类通过语言协作,模型也擅长生成语言,让它们彼此“说话”似乎顺理成章。
但从计算的角度看,这条链路存在一个值得重新审视的环节:一个模型已经处理过输入,却需要再把有用信息组织成文字;另一个模型拿到文字后,又要建立自己的内部表示。
如果协作双方都是计算模型,中间接口是否一定要经过文本?
《Cache-to-Cache: Direct Semantic Communication Between Large Language Models》围绕这个问题提出 C2C:训练转换与融合模块,将一个模型的 KV Cache 用于增强另一个模型的缓存,让接收模型据此生成回答。[1]
这篇文章从这个思路出发,讨论缓存转换究竟改变了什么,以及它走向实际系统时需要回答哪些问题。
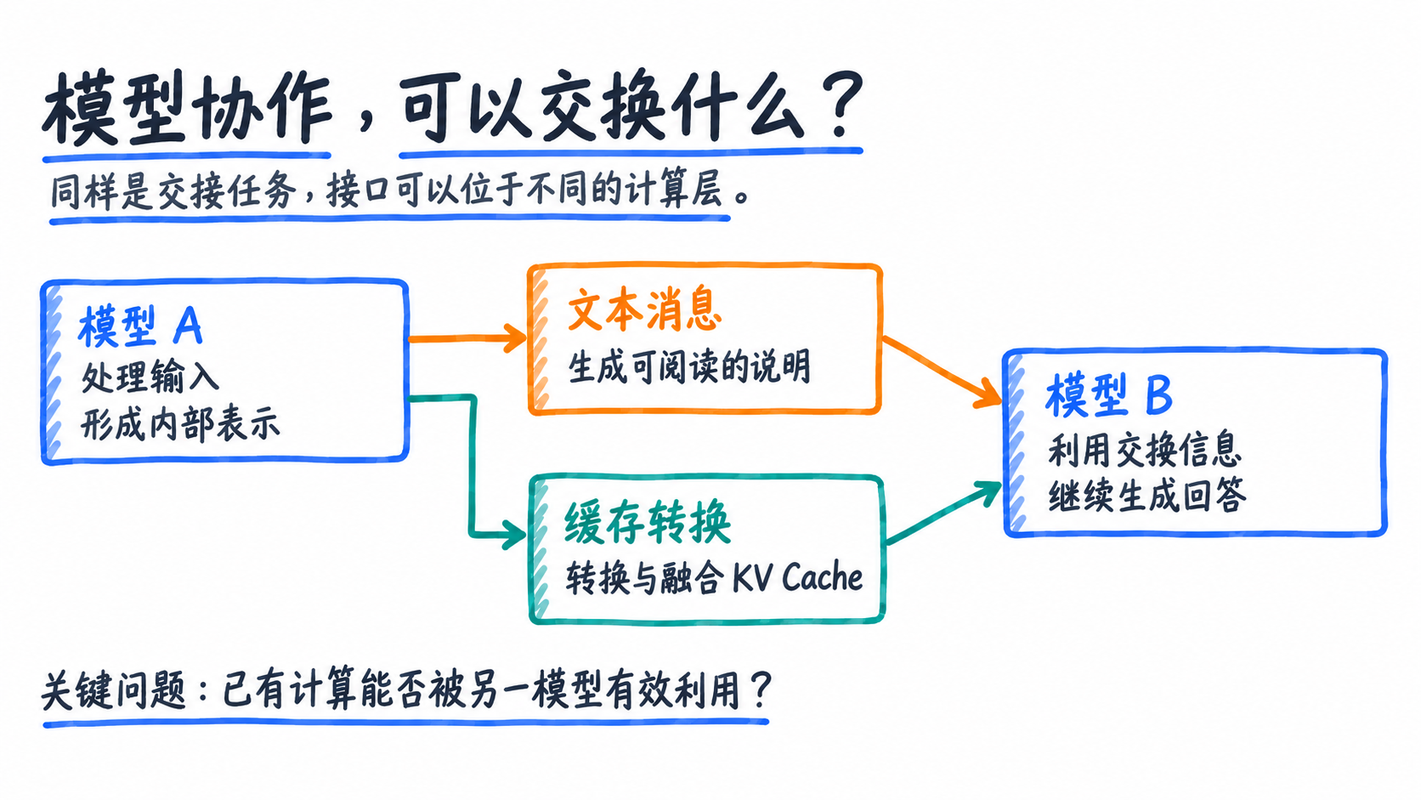
图 1|文本消息与缓存转换,位于不同的交接层。
一、文本通信为什么好用,又为什么值得优化
文本是一个非常成功的模型接口。
它对模型架构没有太多要求。双方无需拥有相同的层数、参数规模或分词器,只需要能够接收和生成文字,就能建立基本协作。文本还便于人类检查:开发者可以看到上游传递了什么、下游误解了什么,并据此修改提示词。
在需要调用外部服务、保留审计记录或让人参与决策的场景里,这些优势尤其重要。
代价则藏在消息的生产与消费过程中。
设想一个模型已经发现:“这次错误与初始化顺序有关,某个对象在依赖准备好之前就被创建了。”为了让另一个模型继续处理,它可能需要交代相关文件、调用链、触发条件和修改建议。这些说明要逐步生成,接收方还要重新读取。
如果只传一句结论,消息很短,但接收方可能缺少足够依据;如果详细解释整个过程,信息更完整,却会增加延迟和上下文成本。
因此,文本协作的优化并不是简单地“把消息变短”。真正的问题是:以多大的成本,传递足够支持下一步计算的信息?
结构化输出、共享文档和更清晰的消息约定,都能改善这件事。缓存转换则探索另一种可能:直接复用部分内部表示,减少中间文字的生成。
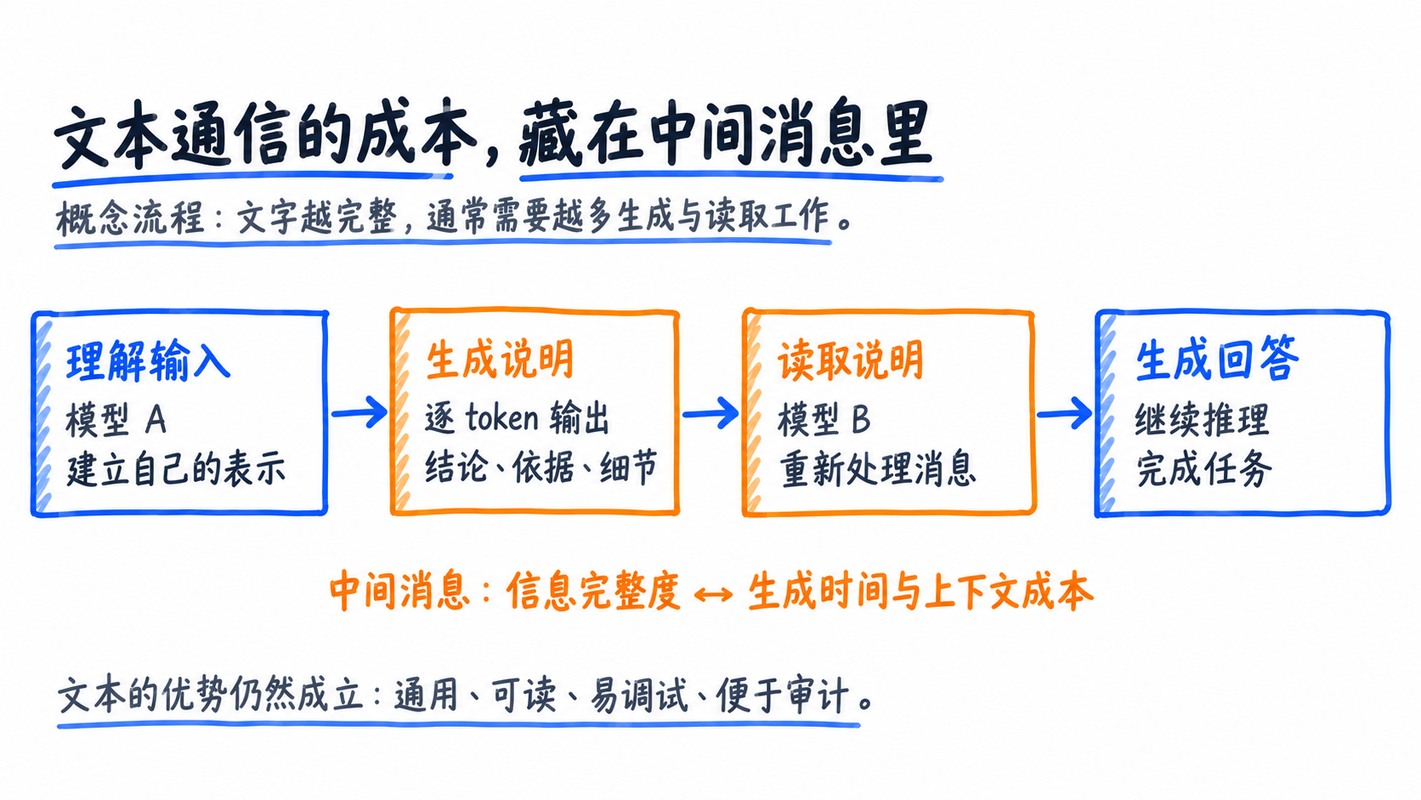
图 2|文本接口的成本与优势需要一起衡量。
二、KV Cache:一段输入留下的计算状态
理解缓存转换,需要先明确 KV Cache 保存的是什么。
在常见的自回归 Transformer 中,生成当前位置的 token,需要通过注意力机制利用前面位置的信息。历史位置产生的 Key 和 Value 可以缓存下来,供后续生成使用,避免重复计算。
这里的“缓存”容易让人联想到数据库中的查询结果,但两者的使用方式不同。
KV Cache 通常不是一条可直接阅读的结论,而是模型各层产生的张量。它依赖输入,也依赖产生它的模型参数和计算结构。
用一个不那么严格的比喻:文本消息像整理好的交接说明,缓存则更接近工作过程中形成的计算材料。材料可能保留某些对后续计算有用的结构,却未必能脱离原来的处理系统直接使用。
这也解释了跨模型共享缓存的难点。
两个模型即使看到同一句话,也可能把它切成不同的 token,使用不同数量的注意力头,在不同层数中建立不同的表示。同一个张量坐标,在另一个模型里没有天然对应的意义。
所以,“能够访问缓存”和“能够有效利用缓存”是两回事。中间需要一个能适配双方表示的接口。
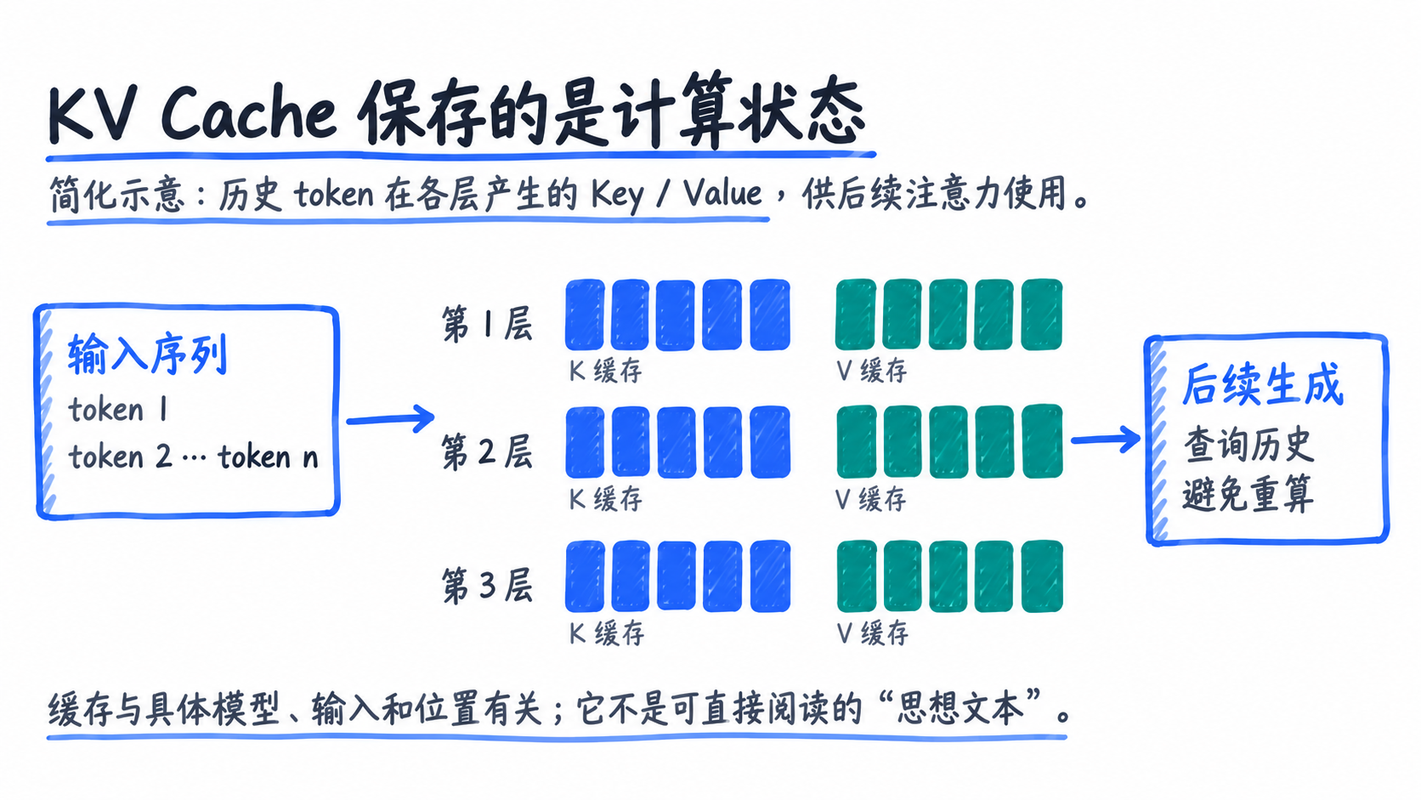
图 3|简化概念图,实际层数、缓存形状随模型变化。
三、从文字交接,到可训练的表示接口
C2C 的基本流程是:两个模型分别处理输入,融合模块转换并组合双方缓存,随后由接收模型完成生成。两个模型在训练时冻结,学习集中在融合接口上;门控用于控制哪些层接受注入。[1,§3]
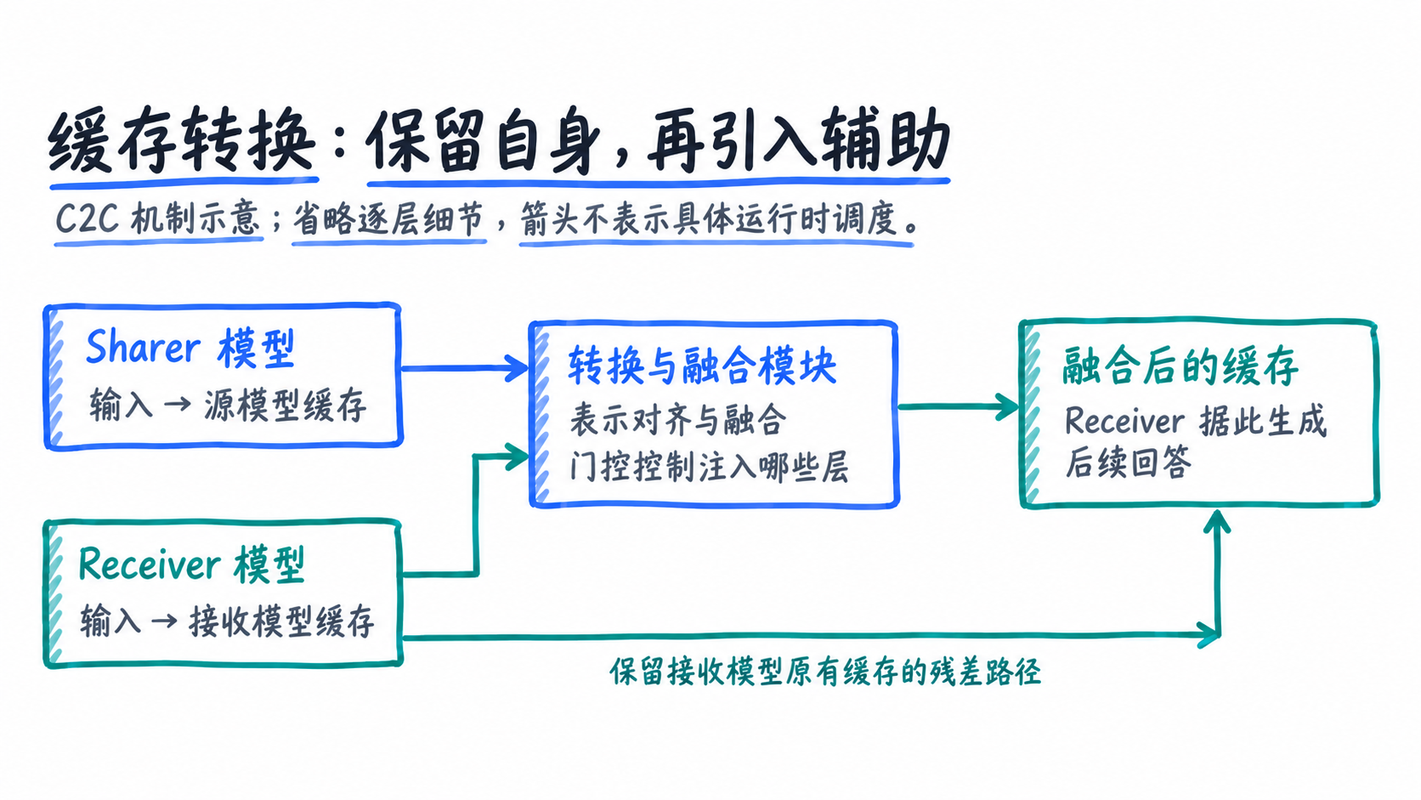
图 4|两个模型均处理输入,融合接口引入辅助表示,同时保留接收模型自身缓存。
这个变化看起来只是换了一种消息格式,实际影响的是协作方式。
使用文本时,上游模型需要决定“应该说什么”,下游模型需要决定“如何理解这段话”。使用可训练的缓存接口时,系统可以通过任务反馈,学习怎样利用另一种表示。
于是,协作能力的一部分从提示词和消息模板,转移到了接口参数中。
这也意味着接口成为系统的一项资产,同时成为一项依赖:它的效果需要训练来建立,模型变化后也需要重新验证。不能因为通信发生在张量层,就假定它比文本更通用。
四、这项工作的意义在哪里
1. 让“已经做过的计算”有机会继续产生价值
多模型系统经常重复处理相同或相近的上下文。不同模型当然可能需要各自计算,但其中是否存在能够跨模型复用的部分,值得研究。
缓存转换把这个问题变成了可以训练和评估的对象:给定一组模型,一个表示接口能否帮助接收方更好地完成任务?
这种思路的价值,不只在于省去几句话。它推动系统设计者重新考虑,模型边界处应该传递哪些计算结果。
2. 为能力互补增加一种实现方式
模型之间的差异,通常通过最终回答体现。一个模型提供答案,另一个模型比较、纠错或补充。
表示层协作则提供了另一种组合位置:在接收模型形成最终回答之前,让它利用来自另一模型的辅助信息。
例如,我们可以设想让专门处理某类输入的模型参与理解,再让擅长组织输出的模型完成回答。这是一个值得验证的架构方向,不能仅凭概念就断言它会优于文本协作。
尤其需要区分“当前任务受到帮助”和“永久获得某种能力”。注入一段与输入有关的缓存,并不意味着接收模型的参数已经学会了源模型的知识。
3. 把通信质量变成训练目标的一部分
文本接口也可以优化,但在许多应用中,开发者主要通过提示词反复试验。可训练的表示接口提供了另一条改进路径:直接利用任务损失调整信息如何被融合。
这并不会消除接口设计问题。相反,它要求我们更认真地考虑训练数据、任务分布和泛化能力。
一个接口在熟悉任务上有效,是否能在新领域继续工作?它学到的是可复用的信息转换,还是依赖训练分布的捷径?这些问题决定了系统的可扩展性。
五、如何看待“更快”的实验结果
论文表 3 给出一组延迟对照:文本协作为 1596 ms,C2C 为 445 ms,接收模型单独运行为 308 ms。这个例子表明,省去中间文本生成可以降低协作开销,但协作仍可能慢于单模型。[1,表 3]
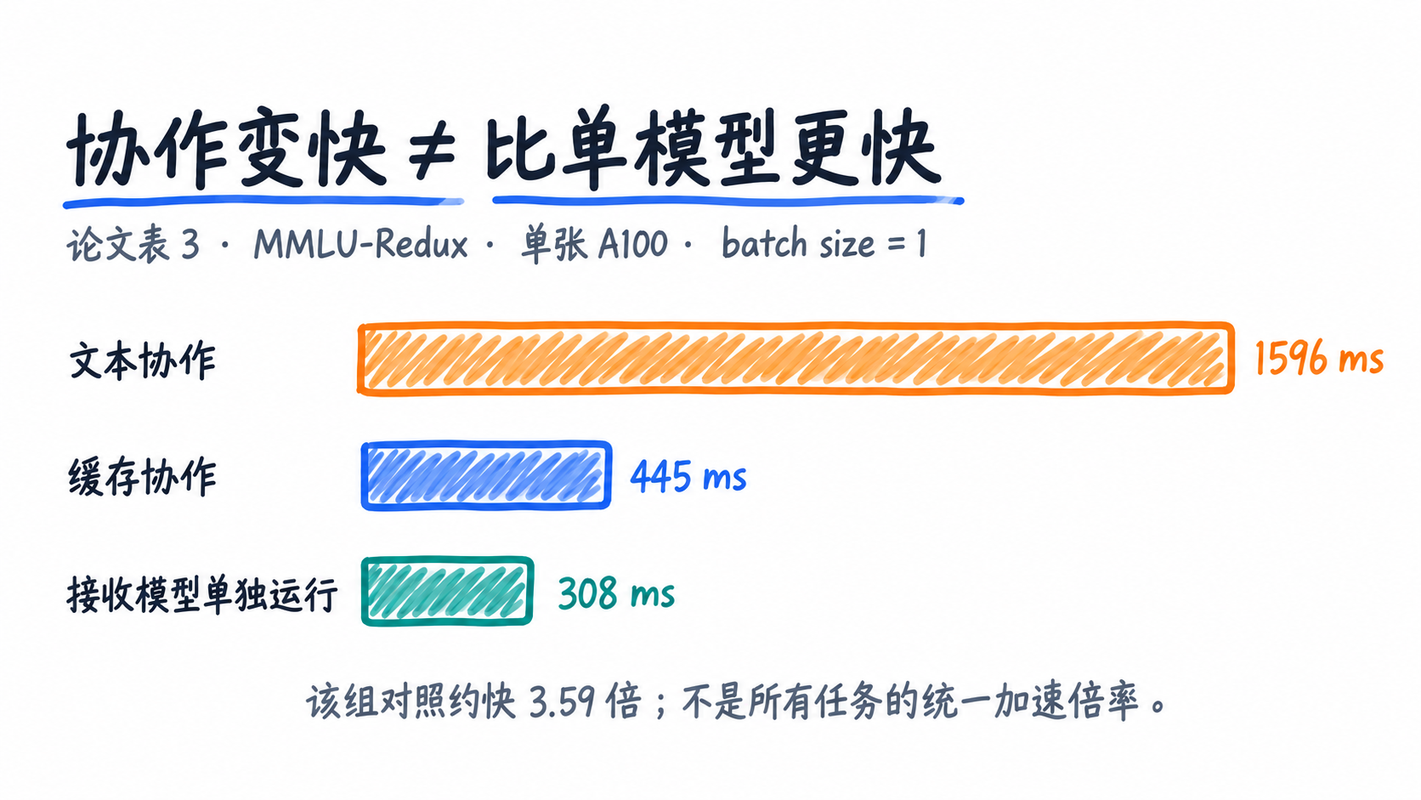
图 5|Sharer 为 Qwen2.5-0.5B-Instruct,Receiver 为 Qwen3-0.6B;数据来自论文表 3。手绘条形长度近似对应数值比例,以标注数值为准。
评价这类结果,需要先确定比较目标。
如果只追求最低延迟,单模型可能已经足够。如果需要协作带来的质量提升,就应比较达到相近质量时,各种方案的时间和资源投入。
我们可以用下面这个简化模型帮助理解成本来源,它不是论文的性能预测公式:
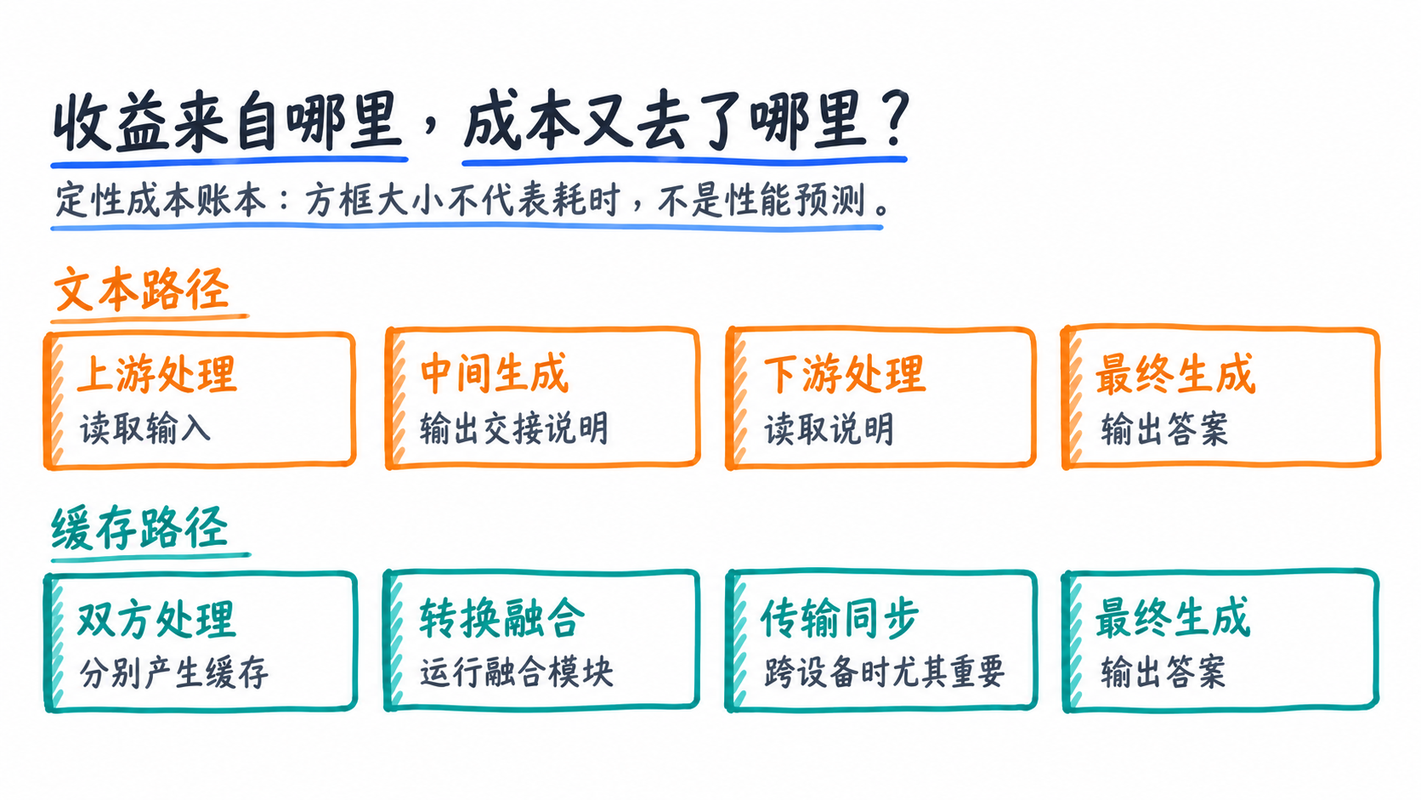
图 6|仅列出成本组成,图块大小不表示耗时;运行中还可能存在并行与重叠。
两条路径都有不可忽略的成本。缓存协作能否获益,要看省去的中间生成,是否足以覆盖新增的融合和传输。
而且,最终回答越长,最终生成在总延迟中占的比例可能越高。即使中间通信明显变快,端到端加速也可能被后续生成稀释。
因此,工程评估至少需要同时记录回答质量、端到端延迟、吞吐和显存占用。只报告某一阶段的加速,很难判断完整系统是否值得采用。
六、缓存转换走向部署,还需要解决什么
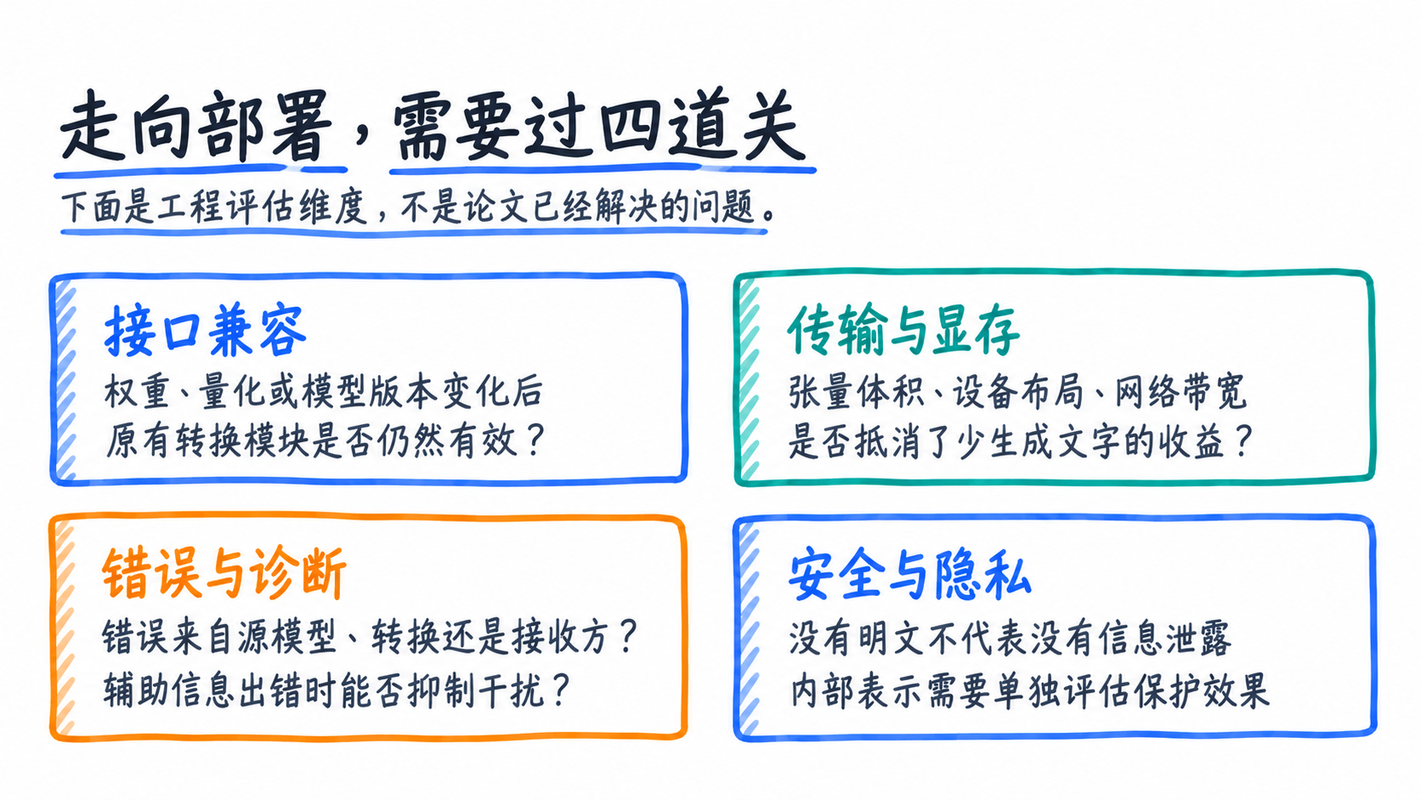
图 7|这些是工程评估问题,不代表已有通用解决方案。
模型升级之后,接口是否仍然可靠
文本接口通常能够容忍一定程度的模型替换。内部表示接口与具体模型的绑定可能更紧。
更换权重、采用不同量化方式,甚至调整推理实现后,都需要验证原来的转换模块是否仍然有效。这里不能预设一定失效,也不能默认可以无缝兼容。
对于维护多个模型版本的团队,接口测试和再训练成本必须进入预算。
张量通信是否真的便宜
少生成 token,并不等于少传输字节。
缓存的体积与序列长度、层数、注意力结构和数值精度有关。如果双方位于不同机器,传输与同步可能成为瓶颈。同一设备上的低延迟表现,不能直接外推到跨网络部署。
这使得模型如何放置、缓存如何选择和压缩,都成为通信设计的一部分。
错误信息如何被识别和阻断
上游模型可能理解错误。表示接口如果有效传递了这份错误,也可能让下游更坚定地走向错误答案。
一个可用的协作系统,需要知道什么时候接受辅助、什么时候保留自身判断,以及什么时候退回其他路径。
评估时应专门构造上游出错的案例,观察接口是否能够抑制干扰。平均准确率之外,负迁移出现的条件同样值得记录。
开发者如何观察内部交接
文本消息可以直接检查,张量则需要额外的诊断工具。
当最终回答错误时,开发者需要区分:是源模型提供了错误信息,转换模块损坏了有用信息,还是接收模型没有正确利用融合结果?
这并非不可解决,但它意味着调试能力需要随通信机制一起建设。更底层的接口,通常也需要更底层的观测手段。
不显示原文,是否就意味着隐私更好
内部表示不是加密结果。它是否泄露输入,取决于攻击者能够访问什么,以及能否通过重建、推断等方式恢复信息。
因此,“消息中没有明文”只能描述表面形式。要提出隐私优势,仍需要明确威胁模型并做独立验证。
七、未来的模型通信,可能是多种接口共同工作
在实际系统中,没有必要让一种接口承担所有职责。
任务目标、用户约束、工具参数和审计记录,适合使用清晰、稳定、可检查的格式。对于固定模型组合、频繁重复的协作链路,则可以探索表示接口是否带来足够收益。
一种值得试验的设计,是保留明确的任务与结果记录,同时在系统内部引入缓存辅助。这样,系统既能利用底层计算,也能保留必要的可观察性。
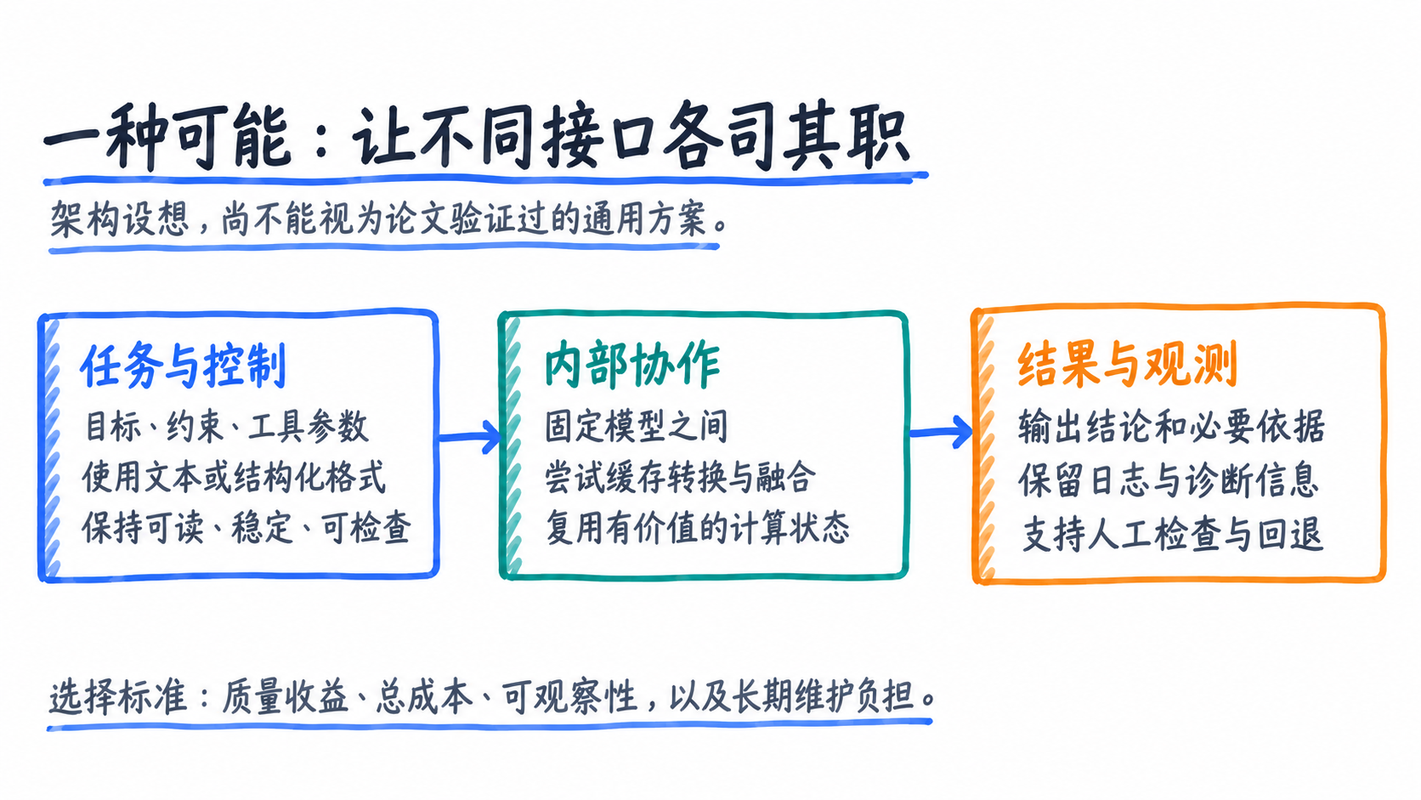
图 8|任务控制、内部协作与结果观测,可以选择不同的接口。
这是一种工程设想,并非论文已经验证的通用架构。它的价值需要通过具体任务来衡量:质量是否提高,成本是否下降,故障是否更难定位,以及模型升级时能否持续维护。
从“文本交换”到“缓存转换”,真正发生的变化,是模型协作的设计空间被扩大了。
当两个模型需要共同完成工作时,我们可以进一步追问:哪些信息适合写成文字,哪些计算状态值得复用,哪些接口需要保持可读,哪些接口可以通过训练获得?
对这些问题的回答,将决定多模型系统能否在能力提升之外,也获得可持续的效率收益。
参考资料
[1] Tianyu Fu et al. Cache-to-Cache: Direct Semantic Communication Between Large Language Models. ICLR 2026,arXiv v2。 论文全文
评论